पहले किनारों के स्पेस हटते हैं, फिर डुप्लिकेट जाँचे जाते हैं
टूल LF या CRLF पर पंक्तियाँ बाँटता है, चुने जाने पर किनारों को ट्रिम करता है, खाली पंक्तियाँ हटाता है, डुप्लिकेट हटाता है और अंत में वैकल्पिक क्रमबद्धता लागू करता है। ट्रिम और खाली पंक्ति हटाना डिफ़ॉल्ट रूप से चालू हैं; क्रमबद्धता बंद है। JavaScript trim() विनिर्देश में परिभाषित दोनों सिरों का व्हाइटस्पेस हटाता है, अंदर के स्पेस बने रहते हैं।
पहली इनपुट पंक्ति में A के दोनों ओर एक स्पेस है। ट्रिम और खाली पंक्ति हटाना चालू होने पर A और B की दो पंक्तियाँ बचती हैं। केवल ट्रिम बंद करने पर स्पेस वाला A, बिना स्पेस वाला A और B बचते हैं। नीचे JSON में उद्धरण चिह्न स्पेस दिखाते हैं; टूल का परिणाम लाइन ब्रेक से अलग होता है।
[" A ", "A", "A", "", "B"]
trim = true:  ["A", "B"]
trim = false: [" A ", "A", "B"]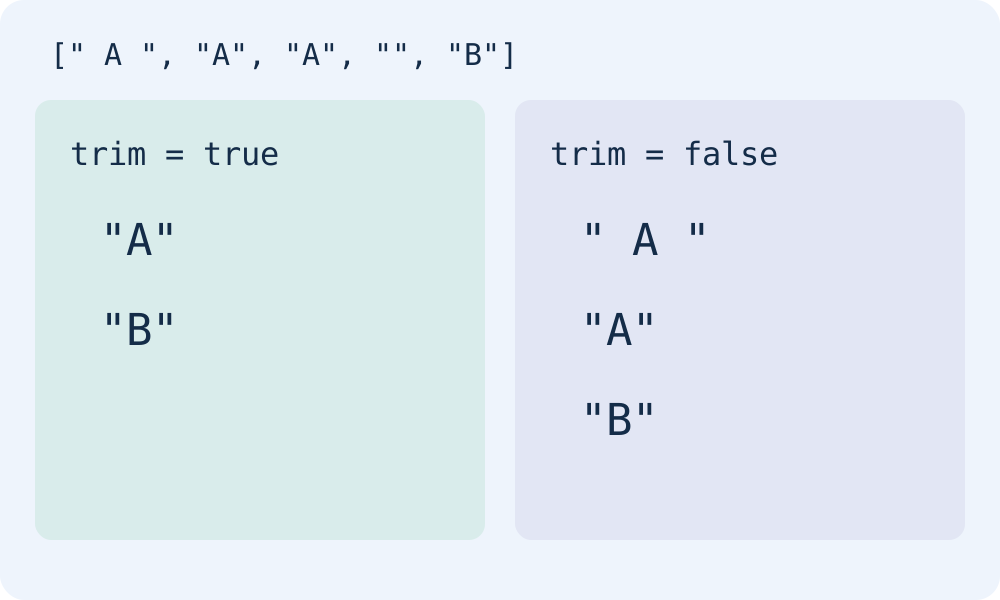
अर्थ या संख्यात्मक मान नहीं, सटीक स्ट्रिंग की तुलना
Set हर समान स्ट्रिंग की एक प्रति रखता है। Apple और apple अलग रहते हैं, जैसे 01 और 1। अंदर के स्पेस अलग होने से A B और A B भी अलग रहते हैं। URL के अर्थ की तुलना, अक्षरों का केस एक करना या Unicode सामान्यीकरण नहीं होता। क्रमबद्धता बंद हो तो पहली बार आने का क्रम बना रहता है।
["Apple", "apple", "01", "1", "A B", "A B"]कीवर्ड सूची के लिए ट्रिम आजमाएँ। इंडेंटेशन या किनारों के स्पेस महत्वपूर्ण हों तो इसे बंद रखें। ट्रिम बंद होने पर भी खाली पंक्ति हटाना केवल व्हाइटस्पेस वाली पंक्तियाँ हटाता है। मूल प्रति रखें और पूरी सूची से पहले कुछ प्रतिनिधि पंक्तियाँ जाँचें। इनपुट या विकल्प बदलने के बाद डुप्लिकेट हटाना फिर चलाएँ।
अक्सर पूछे जाने वाले प्रश्न
क्या क्रमबद्ध करने से अधिक डुप्लिकेट हटते हैं?
नहीं। डुप्लिकेट हटाने के बाद localeCompare पेज की भाषा के अनुसार क्रम देता है। समानता का नियम नहीं बदलता। पंक्तियों को संख्या के रूप में भी नहीं समझा जाता।