एक स्ट्रिंग को चार तरीकों से गिनें
Moyoutil रिक्त स्थान सहित गणना के लिए [...s].length उपयोग करता है, जो कोड पॉइंट गिनता है। JavaScript का s.length UTF-16 इकाइयाँ गिनता है। क्रम में चार व्यक्ति कोड पॉइंट और तीन U+200D जोड़ हैं: कुल सात। UTF-16 लंबाई 11 है और TextEncoder से 25 UTF-8 बाइट मिलते हैं।
const s = "👨👩👧👦";
[...s].length // 7
s.length // 11
new TextEncoder().encode(s).length // 25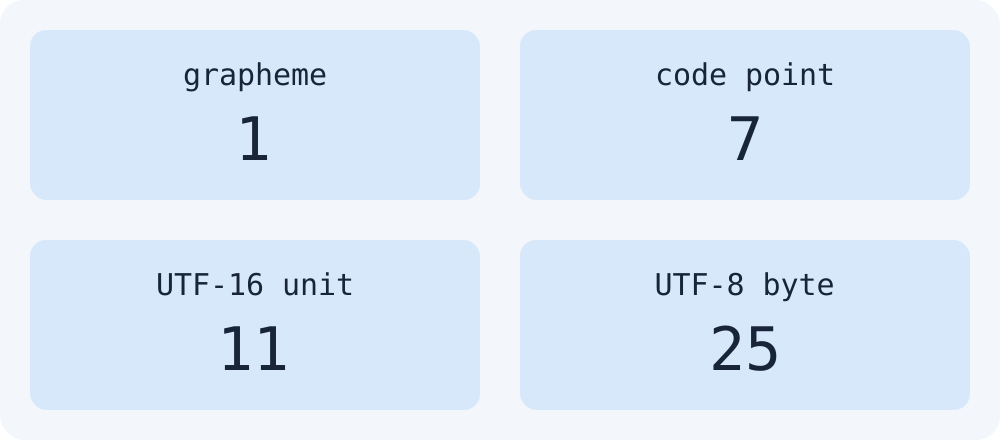
पाठ की सीमाएँ और इनपुट सीमा
Unicode UAX #29 विस्तारित ग्रैफीम सीमाएँ और इमोजी ZWJ क्रम को न बाँटने के नियम बताता है। Intl.Segmenter के grapheme विकल्प से इस उदाहरण में एक भाग मिलता है। ग्रैफीम सीमा वास्तविक चित्र या हर फ़ॉर्म की अक्षर सीमा का आश्वासन नहीं है।
const segmenter = new Intl.Segmenter("en", {
  granularity: "grapheme"
});
[...segmenter.segment(s)].length // 1
Unicode UAX #29: Grapheme Cluster Boundaries
Moyoutil अलग ग्रैफीम या UTF-16 गणना नहीं दिखाता। अक्षर और बाइट काउंटर में क्रम डालने पर रिक्त स्थान सहित 7, बिना रिक्त स्थान 7 और UTF-8 बाइट 25 मिलते हैं। जाँचें कि सीमा अक्षर, बाइट या UTF-16 की है और अंतिम फ़ॉर्म में पुष्टि करें। जोड़ हटाने से मूल क्रम बदलता है।
अक्सर पूछे जाने वाले प्रश्न
क्या हर इमोजी सात अक्षर होता है?
नहीं। यह विशेष परिवार क्रम का परिणाम है। कोड पॉइंट बदलने पर गणना बदलती है। खाली स्ट्रिंग के कोड पॉइंट, UTF-16, UTF-8 और ग्रैफीम सभी 0 हैं।