हाइफ़न और कॉमा शब्द नहीं बाँटते
प्रोग्राम दोनों सिरों पर trim() लगाकर /\s+/u से बाँटता है। खाली या केवल व्हाइटस्पेस इनपुट 0 है। स्पेस, टैब और लाइन ब्रेक समूह अलग करते हैं; हाइफ़न, कॉमा और अपॉस्ट्रॉफ़ी अकेले नहीं। JavaScript \s विनिर्देश के WhiteSpace और LineTerminator से मेल खाता है।
इसलिए state-of-the-art 1, one,two 1 और one, two 2 है। don’t stop में भी दो समूह हैं। केवल विराम चिह्न वाला ... भी 1 है; इसे अर्थपूर्ण शब्दों की संख्या न समझें। कोड में words टूल की शब्द सांख्यिकी है।
countText("state-of-the-art").words // 1
countText("one,two").words          // 1
countText("one, two").words         // 2
countText("don’t stop").words       // 2
countText("...").words              // 1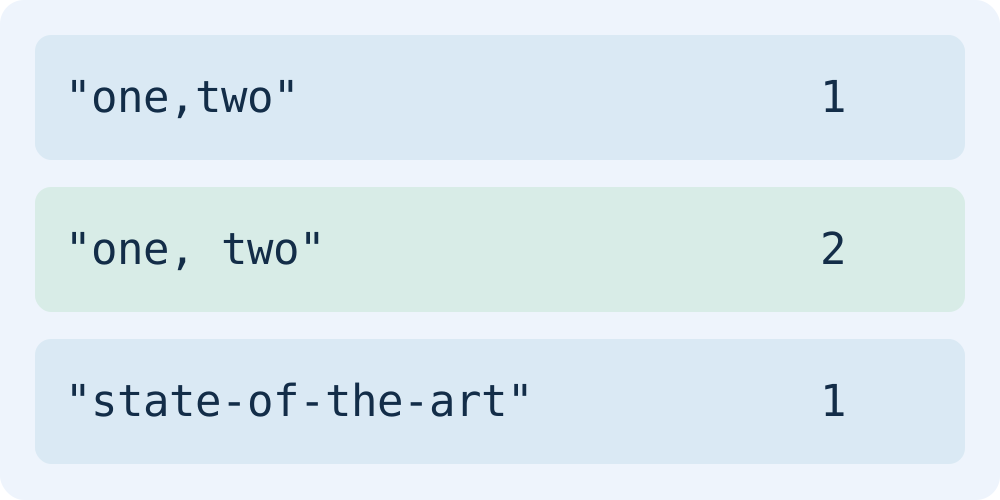
बिना स्पेस का पाठ भाषा के अनुसार नहीं बाँटता
你好世界 इस टूल में 1 है। इसका अर्थ चीनी वाक्य में एक भाषाई शब्द होना नहीं है। Unicode UAX #29 बताता है कि शब्द सीमाएँ केवल व्हाइटस्पेस और विराम चिह्न तक सीमित नहीं हैं और कुछ भाषाओं में अनुकूलन चाहिए। Moyoutil वह एल्गोरिदम या शब्दकोश विश्लेषण लागू नहीं करता।
countText("你好世界").words // 1
countText("one  two").words // 2
countText("one\ntwo").words // 2
countText(" \t\n").words // 0
Unicode UAX #29: Word Boundaries
अक्षर और बाइट काउंटर में पाठ चिपकाएँ; आँकड़े तुरंत बदलते हैं। पूरे मसौदे से पहले हाइफ़न या लाइन ब्रेक वाला नमूना जाँचें। जमा करने के लिए कोई संपादक या तरीका निर्धारित हो तो उसी से अंतिम जाँच करें। गिनती बदलने के लिए अनावश्यक स्पेस जोड़ना पाठ को बदलता है।
अक्सर पूछे जाने वाले प्रश्न
क्या लगातार स्पेस या लाइन ब्रेक गिनती बढ़ाते हैं?
लगातार विभाजक एक सीमा बनाते हैं। one और two के बीच दो स्पेस हों तब भी 2, लाइन ब्रेक हो तब भी 2 है। समान शब्द गिनती के बावजूद स्पेस सहित अक्षर या UTF-8 बाइट संख्या अलग हो सकती है।