Distingue el texto del almacenamiento
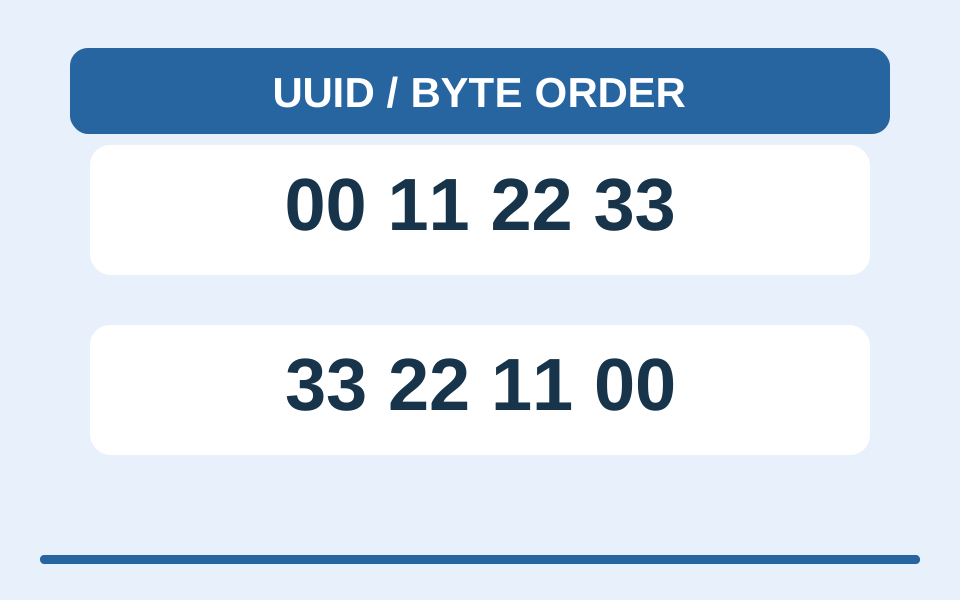
RFC 9562 §4 usa campos big-endian por defecto, salvo una regla explícita del protocolo.
Ida y vuelta del mismo ID en .NET
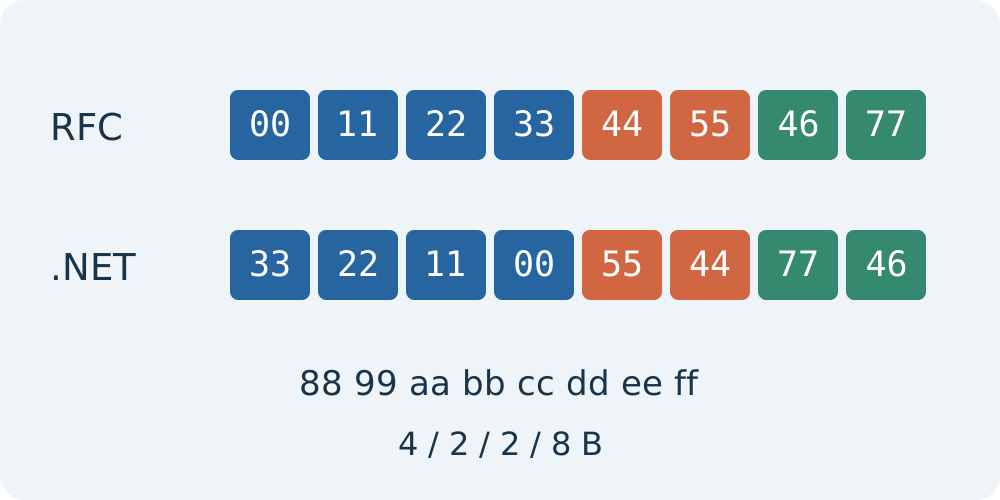
Ejecutamos el código con .NET 10.0.11 el 5 de octubre de 2026. ToByteArray() comienza con 33 22 11 00 55 44 77 46; ToByteArray(true), con 00 11 22 33 44 55 46 77. Ambos terminan con 88 99 aa bb cc dd ee ff. El constructor predeterminado restaura la cadena desde la matriz predeterminada. Para la matriz con true usamos el constructor con ese orden explícito. Invertir los 16 bytes no coincide con ninguno de estos resultados.
$id = [guid]'00112233-4455-4677-8899-aabbccddeeff'
$bytes = $id.ToByteArray()
($bytes | ForEach-Object { $_.ToString('x2') }) -join ' '
# 33 22 11 00 55 44 77 46 88 99 aa bb cc dd ee ff
([guid]::new($bytes)).ToString()
# 00112233-4455-4677-8899-aabbccddeeff
$network = $id.ToByteArray($true)
([guid]::new($network, $true)).ToString()
# 00112233-4455-4677-8899-aabbccddeeffQué puedes comprobar en Moyoutil
El generador actual crea listas de cadenas v4 y cambia mayúsculas o la presentación en texto/JSON. No exporta matrices binarias ni convierte el orden GUID. Guarda las cadenas para probar la integración y alinea las reglas de las API emisora y receptora. Compara la cadena, los 16 bytes, los tres primeros grupos y los ocho finales. Recomendamos revisar el contrato de la API antes de invertir bytes para forzar la coincidencia.
const id = '00112233-4455-4677-8899-aabbccddeeff';
const hex = id.replaceAll('-', '');
const bytes = Uint8Array.from(hex.match(/../g), s => parseInt(s, 16));
console.log(new TextEncoder().encode(hex).length, bytes.length);
// 32 16
Preguntas frecuentes
¿Los 32 caracteres sin guiones son un archivo de 16 bytes?
No. En el código, UTF-8 codifica esos caracteres en 32 bytes; interpretar cada par hexadecimal produce 16 bytes. Alinea también la representación de entrada al comparar hashes.