Distinguer le texte du stockage
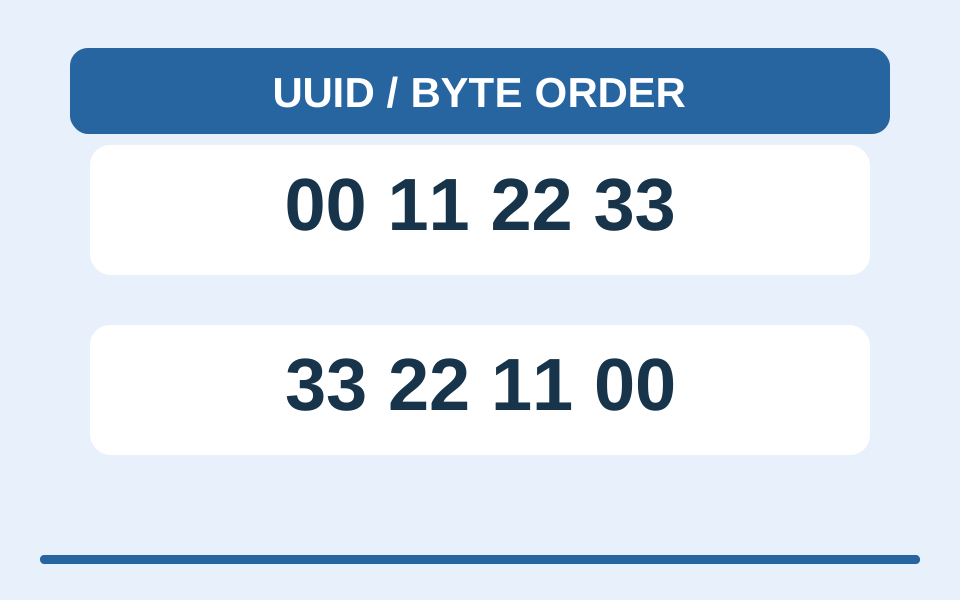
RFC 9562 §4 adopte des champs big-endian par défaut, sauf règle explicite du protocole.
Aller-retour du même identifiant dans .NET
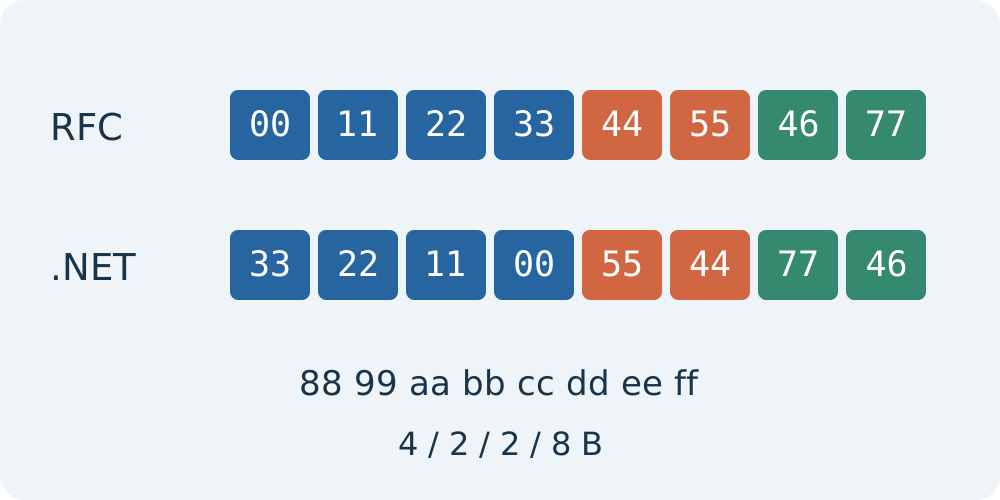
Nous avons exécuté le code avec .NET 10.0.11 le 5 octobre 2026. ToByteArray() commence par 33 22 11 00 55 44 77 46 ; ToByteArray(true), par 00 11 22 33 44 55 46 77. Les deux finissent par 88 99 aa bb cc dd ee ff. Le constructeur par défaut restaure la chaîne depuis le tableau par défaut. Pour le tableau produit avec true, nous avons utilisé le constructeur précisant ce même ordre. Inverser les 16 octets ne correspond à aucun de ces résultats.
$id = [guid]'00112233-4455-4677-8899-aabbccddeeff'
$bytes = $id.ToByteArray()
($bytes | ForEach-Object { $_.ToString('x2') }) -join ' '
# 33 22 11 00 55 44 77 46 88 99 aa bb cc dd ee ff
([guid]::new($bytes)).ToString()
# 00112233-4455-4677-8899-aabbccddeeff
$network = $id.ToByteArray($true)
([guid]::new($network, $true)).ToString()
# 00112233-4455-4677-8899-aabbccddeeffCe que Moyoutil permet de vérifier
Le générateur actuel crée des listes de chaînes v4 et change la casse ou l’affichage texte/JSON. Il n’exporte pas de tableau binaire et ne convertit pas l’ordre GUID. Conservez les chaînes pour tester l’intégration et accordez les règles des deux API. Comparez la chaîne, la longueur de 16 octets, les trois premiers groupes et les huit derniers octets. Vérifiez le contrat de l’API avant d’inverser des octets pour forcer une correspondance.
const id = '00112233-4455-4677-8899-aabbccddeeff';
const hex = id.replaceAll('-', '');
const bytes = Uint8Array.from(hex.match(/../g), s => parseInt(s, 16));
console.log(new TextEncoder().encode(hex).length, bytes.length);
// 32 16
Questions fréquemment posées
Les 32 caractères sans tirets sont-ils un fichier de 16 octets ?
Non. Dans le code, UTF-8 encode ces caractères en 32 octets ; interpréter chaque paire hexadécimale produit 16 octets. Accordez aussi la représentation d’entrée avant de comparer les empreintes.