Separe texto e armazenamento
RFC 9562 §4 adota campos big-endian por padrão, salvo regra explícita do protocolo.
Ida e volta do mesmo ID no .NET
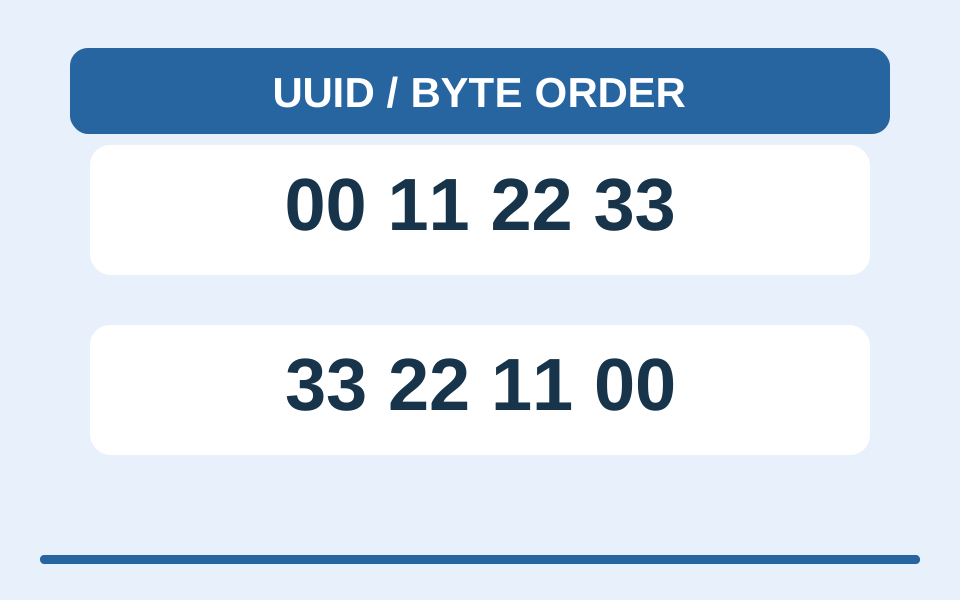
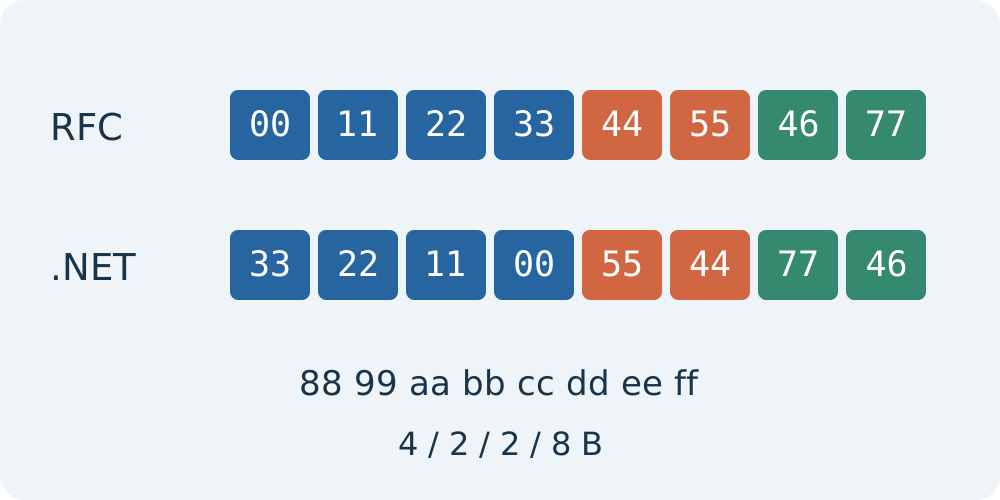
Executamos o código no .NET 10.0.11 em 5 de outubro de 2026. ToByteArray() começa com 33 22 11 00 55 44 77 46; ToByteArray(true), com 00 11 22 33 44 55 46 77. Ambos terminam em 88 99 aa bb cc dd ee ff. O construtor padrão restaura a string a partir da matriz padrão. Para a matriz com true usamos o construtor com essa ordem explícita. Inverter os 16 bytes não corresponde a nenhum resultado deste exemplo.
$id = [guid]'00112233-4455-4677-8899-aabbccddeeff'
$bytes = $id.ToByteArray()
($bytes | ForEach-Object { $_.ToString('x2') }) -join ' '
# 33 22 11 00 55 44 77 46 88 99 aa bb cc dd ee ff
([guid]::new($bytes)).ToString()
# 00112233-4455-4677-8899-aabbccddeeff
$network = $id.ToByteArray($true)
([guid]::new($network, $true)).ToString()
# 00112233-4455-4677-8899-aabbccddeeffO que verificar no Moyoutil
O gerador atual cria listas de strings v4 e muda maiúsculas ou a apresentação em texto/JSON. Não exporta matrizes binárias nem converte a ordem GUID. Guarde as strings para testes de integração e alinhe as regras das APIs de envio e recebimento. Compare a string, os 16 bytes, os três primeiros grupos e os oito finais. Recomendamos verificar o contrato da API antes de inverter bytes para forçar uma correspondência.
const id = '00112233-4455-4677-8899-aabbccddeeff';
const hex = id.replaceAll('-', '');
const bytes = Uint8Array.from(hex.match(/../g), s => parseInt(s, 16));
console.log(new TextEncoder().encode(hex).length, bytes.length);
// 32 16
Perguntas frequentes
Os 32 caracteres sem hífens são um arquivo de 16 bytes?
Não. No código, UTF-8 codifica esses caracteres em 32 bytes; interpretar cada par hexadecimal gera 16 bytes. Alinhe a representação de entrada também ao comparar hashes.