文字列と保存時の順序を区別する
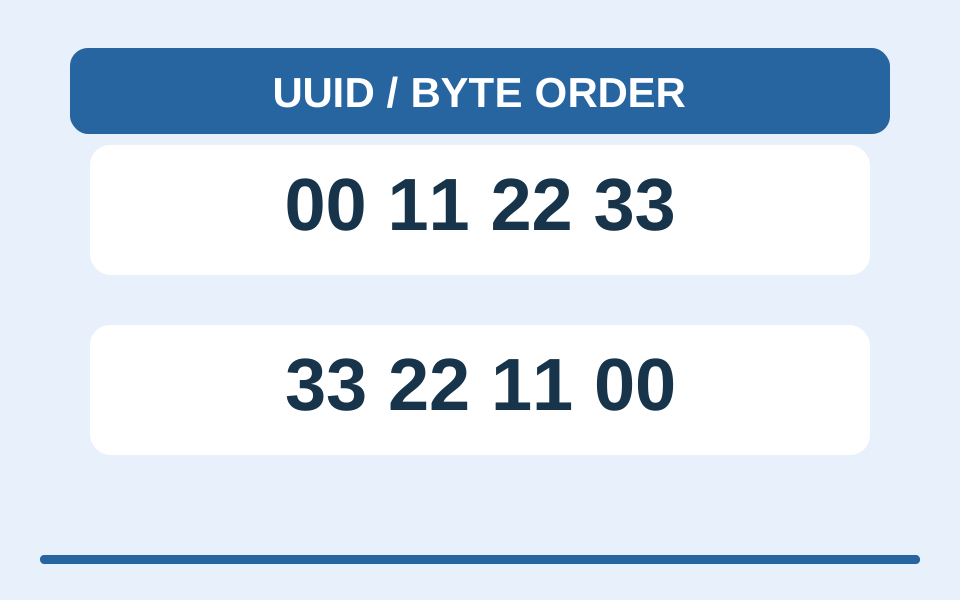
RFC 9562 §4の既定はフィールドごとのビッグエンディアンです。明示的なプロトコル指定は例外です。
.NETで同じIDを往復させる
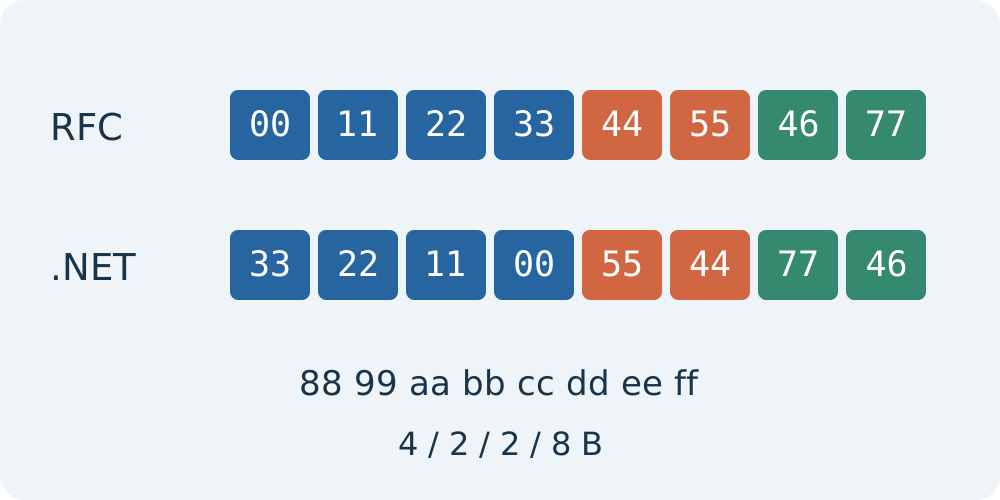
2026年10月5日に.NET 10.0.11でコードを実行しました。既定のToByteArray()は33 22 11 00 55 44 77 46、ToByteArray(true)は00 11 22 33 44 55 46 77で始まります。両方とも末尾は88 99 aa bb cc dd ee ffです。既定の配列を既定のコンストラクターで読むと元の文字列に戻ります。trueで作った配列には同じエンディアンを指定したコンストラクターを組み合わせました。16バイト全体の反転は、この例のどちらとも一致しません。
$id = [guid]'00112233-4455-4677-8899-aabbccddeeff'
$bytes = $id.ToByteArray()
($bytes | ForEach-Object { $_.ToString('x2') }) -join ' '
# 33 22 11 00 55 44 77 46 88 99 aa bb cc dd ee ff
([guid]::new($bytes)).ToString()
# 00112233-4455-4677-8899-aabbccddeeff
$network = $id.ToByteArray($true)
([guid]::new($network, $true)).ToString()
# 00112233-4455-4677-8899-aabbccddeeffMoyoutilで確認できること
現在のUUID生成器はv4文字列の一覧を作り、大文字小文字やテキスト・JSON表示を変更します。バイナリ出力やGUIDのエンディアン変換はありません。文字列を連携テスト用に保存し、送受信APIの規則を合わせてください。不一致では文字列、16バイトの長さ、先頭3グループ、末尾8バイトの順に比べます。無理に反転する前にAPIの契約を確認することを勧めます。
const id = '00112233-4455-4677-8899-aabbccddeeff';
const hex = id.replaceAll('-', '');
const bytes = Uint8Array.from(hex.match(/../g), s => parseInt(s, 16));
console.log(new TextEncoder().encode(hex).length, bytes.length);
// 32 16
よくある質問
ハイフンを消した32文字は16バイトのファイルですか?
いいえ。下のコードでは32文字をUTF-8にすると32バイト、16進数2文字を1バイトとして読むと16バイトです。ハッシュ比較でも入力の表現を揃えてください。