原文の行と値の行は異なります
JSON原文の文字列内ではバックスラッシュとnが改行を表します。バックスラッシュを二つ書くと、解析後の値にはバックスラッシュとnの二文字が残ります。以下は両方とも有効ですが、textの長さは3と4です。
{"text":"A\nB"}
{"text":"A\\nB"}

JSON.parse('{"text":"A\\nB"}').text.length // 3
JSON.parse('{"text":"A\\\\nB"}').text.length // 4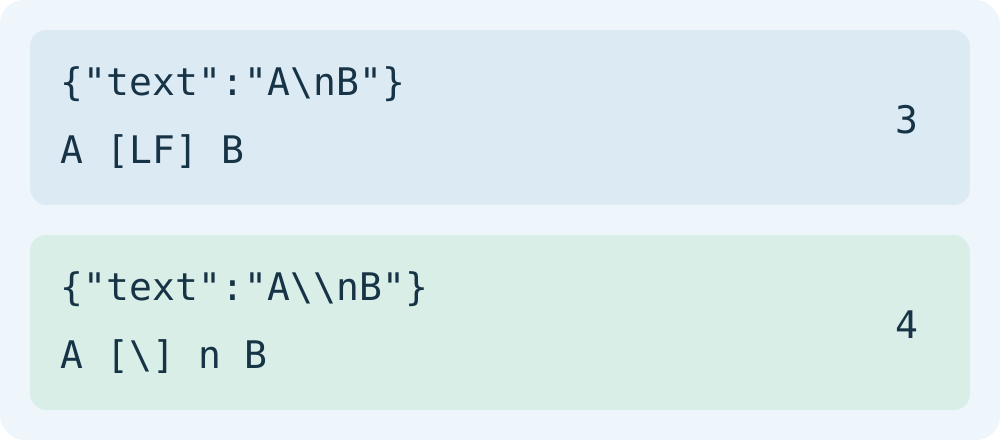
文字列内の実際の改行はエラーです
RFC 8259は文字列内のU+0000〜U+001F制御文字のエスケープを要求します。実際のLFも対象です。トークン間ではLF・CR・タブ・空白が使えます。今回の検証では文字列内の実際のLFは拒否され、複数行のオブジェクトは通過しました。
const invalid = '{"text":"A' + '\n' + 'B"}';
formatJSON(invalid); // throws

formatJSON('{\n"text":"AB"\n}'); // accepted整形と値の解釈を区別する
Moyoutilは原文の文字列トークンを保ち、外側のインデントを変更します。\nを値内の実際の改行として表示する機能ではありません。圧縮も文字列のエスケープを保ちます。失敗時は指摘位置付近の引用符とバックスラッシュを確認してください。全体に一括追加すると正しい値も変わります。
例を入れて整形・検証し、圧縮結果も比較してください。改行が必要な値はJSON生成時にJSON.stringifyで直列化し、JSON.parse後の値が意図通りか確認します。文法検証はAPIスキーマの必須項目検証ではありません。
よくある質問
JSON圧縮で値の改行も消えますか?
いいえ。圧縮は文字列の外側の空白を減らします。このツールは文字列内のエスケープを保つため、解析後の値の改行も残ります。