ハイフンとコンマでは分割しない
両端をtrim()で処理してから/\s+/uで分割します。空の入力や空白だけの入力は0です。空白、タブ、改行は区切りになりますが、ハイフン、コンマ、アポストロフィだけでは分割しません。JavaScriptの\sは規格のWhiteSpaceとLineTerminatorに該当します。
state-of-the-artは1、one,twoは1、one, twoは2です。don’t stopも2つのまとまりです。句読点だけの...も1になるため、意味のある単語数とは解釈しないでください。下のwordsはツールの単語統計です。
countText("state-of-the-art").words // 1
countText("one,two").words          // 1
countText("one, two").words         // 2
countText("don’t stop").words       // 2
countText("...").words              // 1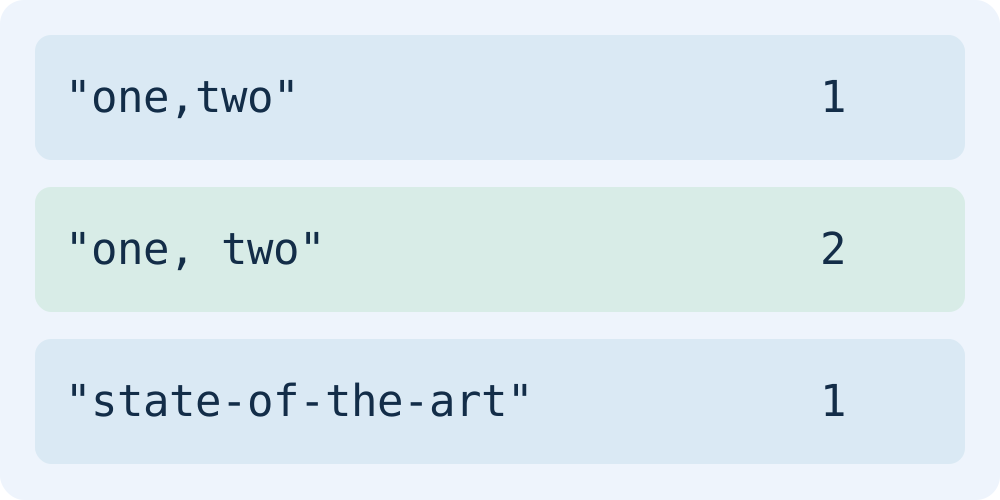
空白のない文章を言語別に分解しない
你好世界はこのツールでは1です。中国語の文章が言語学的に1語という意味ではありません。Unicode UAX #29は単語境界が空白と句読点だけに限られず、一部の言語では調整が必要と説明します。Moyoutilはそのアルゴリズムや辞書による分析を適用しません。
countText("你好世界").words // 1
countText("one  two").words // 2
countText("one\ntwo").words // 2
countText(" \t\n").words // 0
Unicode UAX #29: Word Boundaries
文字数・バイト計算に貼り付けると統計がすぐ更新されます。ハイフンや改行を含む代表例を確認してから原稿全体を入れてください。提出先の指定する編集ソフトや集計規則で最後に確認します。数値を変えるための不要な空白は文章自体を変えてしまいます。
よくある質問
連続する空白や改行で語数は増えますか?
連続した区切りは1つの境界として処理します。oneとtwoの間が空白2個でも改行でも2です。語数が同じでも、空白込み文字数やUTF-8バイト数は異なることがあります。