같은 문자열을 네 기준으로 세기
Moyoutil의 공백 포함 값은 문자열을 펼친 [...s].length로 계산합니다. 이 방식은 코드 포인트를 세며, JavaScript의 s.length는 UTF-16 코드 단위를 셉니다. 예제의 가족 시퀀스에는 사람 코드 포인트 4개와 연결 문자 U+200D 3개가 있어 합계 7개입니다. UTF-16 길이는 11, TextEncoder로 얻는 UTF-8 길이는 25바이트입니다.
const s = "👨👩👧👦";
[...s].length // 7
s.length // 11
new TextEncoder().encode(s).length // 25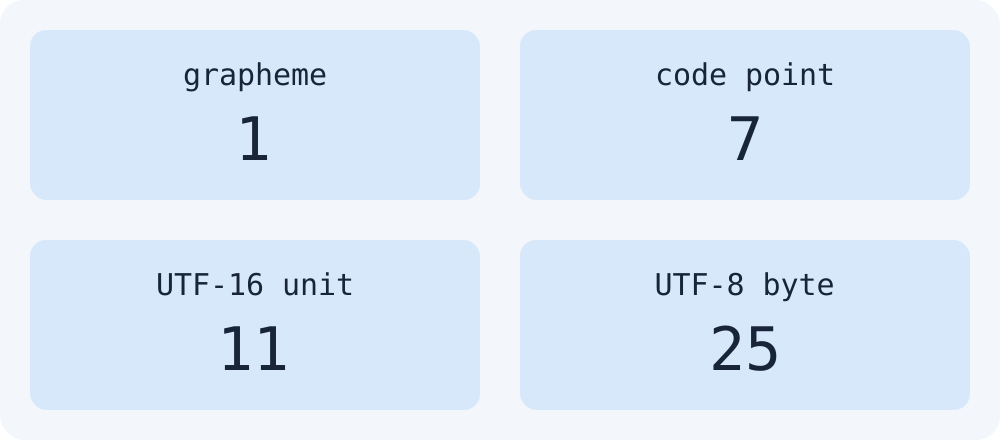
보이는 글자에 가까운 경계와 입력 제한
Unicode UAX #29는 확장 그래핌 클러스터 경계를 설명하며 이모지 ZWJ 시퀀스 내부를 나누지 않는 규칙을 둡니다. 이 예제는 Intl.Segmenter의 grapheme 설정으로 실행했을 때 1개로 나뉩니다. 그래핌 경계는 그림의 실제 렌더링이나 모든 제출처의 글자 수 규칙과 동일하다는 뜻이 아닙니다.
const segmenter = new Intl.Segmenter("en", {
  granularity: "grapheme"
});
[...segmenter.segment(s)].length // 1
Unicode UAX #29: Grapheme Cluster Boundaries
Moyoutil은 그래핌 수와 UTF-16 길이를 별도 통계로 제공하지 않습니다. 글자 수·바이트 계산기에 이 시퀀스를 넣으면 공백 포함 7, 공백 제외 7, UTF-8 바이트 25를 확인할 수 있습니다. 제한이 글자 수인지 바이트 수인지, UTF-16 기준인지 먼저 확인하고 제출처에서 최종 검사하세요. 연결 문자를 임의로 지우면 원문 시퀀스가 달라집니다.
자주 묻는 질문
이모지는 모두 7글자로 세나요?
아니요. 여기의 특정 가족 시퀀스 결과입니다. 입력에 포함된 코드 포인트가 다르면 집계도 달라집니다. 빈 문자열의 코드 포인트·UTF-16·UTF-8·그래핌 수는 모두 0입니다.