Dieselbe Zeichenfolge auf vier Arten zählen
Moyoutil berechnet die Anzahl einschließlich Leerzeichen mit [...s].length. Das zählt Codepunkte; JavaScript s.length zählt UTF-16-Codeeinheiten. Die Sequenz enthält vier Personen-Codepunkte und drei U+200D-Verbindungen, insgesamt sieben. Die UTF-16-Länge ist 11; TextEncoder liefert 25 UTF-8-Bytes.
const s = "👨👩👧👦";
[...s].length // 7
s.length // 11
new TextEncoder().encode(s).length // 25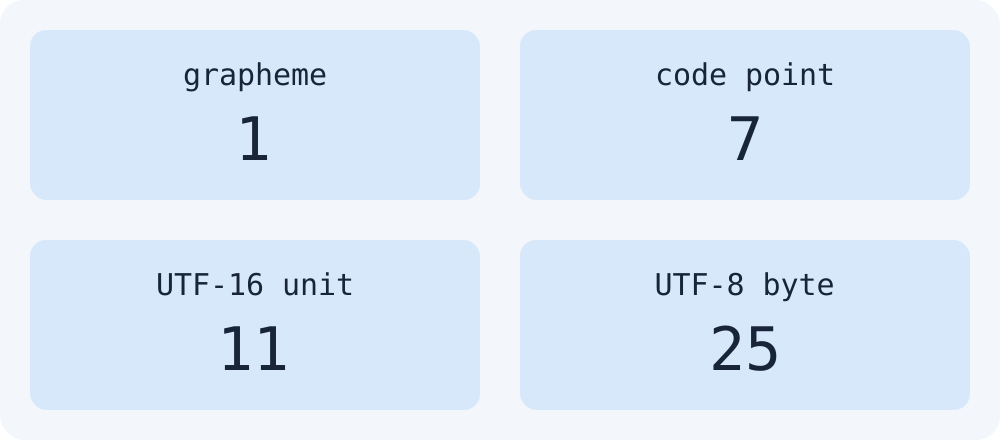
Textgrenzen und Eingabelimits
Unicode UAX #29 beschreibt erweiterte Graphemgrenzen und Regeln gegen Trennungen innerhalb von Emoji-ZWJ-Sequenzen. Intl.Segmenter mit grapheme liefert hier ein Segment. Eine Graphemgrenze garantiert weder die Darstellung noch die Zählregeln jedes Formulars.
const segmenter = new Intl.Segmenter("en", {
  granularity: "grapheme"
});
[...segmenter.segment(s)].length // 1
Unicode UAX #29: Grapheme Cluster Boundaries
Moyoutil zeigt keine separaten Graphem- oder UTF-16-Zahlen. Füge die Sequenz im Zeichen- und Bytezähler ein: 7 mit Leerzeichen, 7 ohne und 25 UTF-8-Bytes. Prüfe, ob das Limit Zeichen, Bytes oder UTF-16 meint, und kontrolliere im Zielformular. Das Entfernen von Verbindungszeichen verändert die Sequenz.
Häufig gestellte Fragen
Zählt jedes Emoji als sieben Zeichen?
Nein. Das gilt für diese konkrete Familiensequenz. Andere Codepunkte ergeben andere Zahlen. Eine leere Zeichenfolge hat null Codepunkte, UTF-16-Einheiten, UTF-8-Bytes und Grapheme.