화면에 보이는 모양과 코드 포인트 배열은 다를 수 있습니다
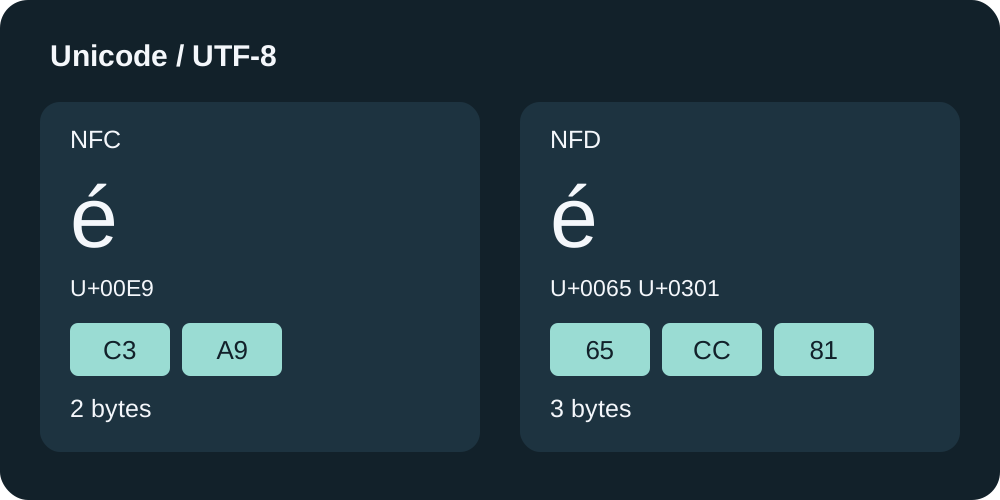
이 글의 첫 예시는 U+00E9 하나로 표현한 é와, U+0065 뒤에 U+0301을 붙인 표현입니다. 후자는 e와 결합 악센트 두 코드 포인트입니다. 표시 모양은 글꼴과 렌더링 환경에 따라 달라질 수 있으므로 원문 배열로 구분합니다. Unicode는 이 두 표현을 정준적으로 동등한 사례로 다룹니다.
실제 도구 함수로 확인한 글자 수·바이트·Base64
2026년 10월 5일 프로젝트의 countText, base64, digest 함수로 확인했습니다. 글자 수 열은 Moyoutil의 코드 포인트 개수이며 사람이 한 글자로 인식하는 단위의 개수와 같다는 뜻은 아닙니다. 도구는 이 입력들을 자동으로 NFC로 바꾸지 않습니다.
| 코드 포인트 | 글자 수 | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
한글 예시도 완성된 음절과 조합용 자모 배열을 비교한 것입니다. 이 결과는 위 입력에 대한 측정이며 모든 한글이나 모든 악센트 문자에 같은 바이트 수가 적용되는 것은 아닙니다. TextEncoder는 UTF-8을 사용합니다.
해시는 화면 모양 대신 입력 바이트를 비교합니다
위 두 é 표현의 UTF-8 바이트를 Moyoutil SHA-256 함수에 전달하면 아래 결과가 나옵니다. 이 사례에서는 서로 다른 값입니다. 텍스트 모드에는 자동 정규화가 없으며 파일 모드는 파일 바이트를 그대로 사용합니다. 텍스트로 붙여 넣은 값의 해시가 원본 파일 전체의 해시와 같다고 가정하지 마세요.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
글자 수 도구에 각 표현을 따로 입력해 바이트 수를 확인하고, SHA 해시 도구의 텍스트 모드에서 같은 입력의 SHA-256을 계산하세요. 같은 모양을 키보드로 다시 치면 원래 배열이 재현되지 않을 수 있으므로 아래 코드의 이스케이프 표현으로 원문을 생성하는 방법도 사용할 수 있습니다.
NFC 비교를 재현하되 원문은 보존하세요
JavaScript normalize는 NFC, NFD, NFKC, NFKD 형식을 지원합니다. 아래 예시는 두 é 표현을 NFC로 만든 뒤 비교합니다. NFC는 정준 분해 후 가능한 정준 합성을 적용하는 형식입니다. 두 원문이 처음부터 같은 배열이었다는 뜻은 아닙니다.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
NFKC는 호환성 차이도 정리하며 이 예시의 원 안 숫자 ①을 1로 바꿉니다. 구분이 중요한 자료에 무조건 적용하면 원문이 바뀔 수 있습니다. 정규화는 대소문자 변환이나 공백 제거와도 별개의 작업입니다.
바이트 제한과 체크섬 오류를 조사하는 순서
- 원본을 보관하고 텍스트끼리 비교하는지 파일 전체를 비교하는지 구분합니다.
- UTF-8 바이트 수를 확인하고 앞뒤 공백과 줄바꿈을 별도로 점검합니다.
- 받는 시스템이 정규화 형식을 명시했는지 확인합니다. 규칙이 없다면 임의로 원문을 바꾸지 않습니다.
- 정규화가 합의된 텍스트 비교라면 복사본에 같은 형식을 적용한 뒤 다시 바이트와 해시를 확인합니다.
- 원본 파일 무결성 검사에서는 파일을 편집하거나 정규화하지 않고 제공된 체크섬과 비교합니다.
현재 Moyoutil의 글자 수·Base64·SHA 도구는 정규화 편집기가 아닙니다. 정규화를 자동 수행하는 버튼은 제공하지 않습니다. 이 글의 코드는 기술 재현용이며 어떤 외부 서비스의 제출 규칙을 대신하지 않습니다.
자주 묻는 질문
NFC로 바꾸면 모든 글자의 용량이 줄어드나요?
아닙니다. 이 글의 두 예시에서는 바이트 수가 줄지만 모든 입력에 대한 용량 감소 규칙은 아닙니다. 변환 뒤 실제 바이트 수를 확인하세요.
같아 보이는 비밀번호도 자동으로 정규화해야 하나요?
이 글은 인증 시스템의 비밀번호 처리 규칙을 정하지 않습니다. 해당 시스템의 명시된 규칙 없이 원문을 임의로 변경하지 마세요.