Die Datei kann EF BB BF enthalten
Unicode nennt EF BB BF als UTF-8-BOM. In UTF-8 dient es als Kodierungssignatur, nicht als Wechsel der Bytereihenfolge. Unser Beispiel ergänzt abc, 61 62 63, zu sechs Bytes. Moyoutils Dateimodus liest Originalbytes mit arrayBuffer; der Textmodus kodiert mit TextEncoder als UTF-8.
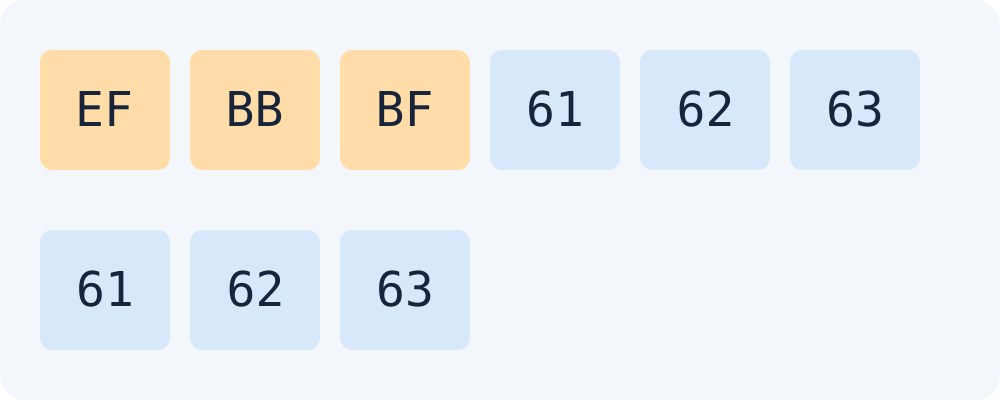
ignoreBOM: true behält das Zeichen
TextDecoder lässt standardmäßig das anfängliche BOM weg und liefert abc. ignoreBOM: true überspringt diese Behandlung und behält U+FEFF. Erneutes Kodieren der Standardausgabe liefert drei Bytes; ihr SHA-256 unterscheidet sich hier vom sechs Byte langen Original. Dies gilt nicht zwangsläufig für jeden Editor oder Kopiervorgang.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3Zum Vergleich der Originaldatei verwenden Sie den Dateimodus. Nur sichtbares abc einzufügen ist eine andere Eingabe. Bleibt U+FEFF im String, werden seine Bytes mitkodiert. Entfernen Sie das Original-BOM nicht nur für einen passenden Hash; prüfen Sie Algorithmus und Dateiversion.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
Häufig gestellte Fragen
Wird U+FEFF in der Mitte entfernt?
Dieses Beispiel entfernt nur das anfängliche BOM. Ein internes U+FEFF bleibt; ignoreBOM: true behält auch das erste Zeichen. Code und leere Eingabe wurden ausgeführt.