Das Aussehen und die Anordnung der Codepunkte auf dem Bildschirm können variieren.
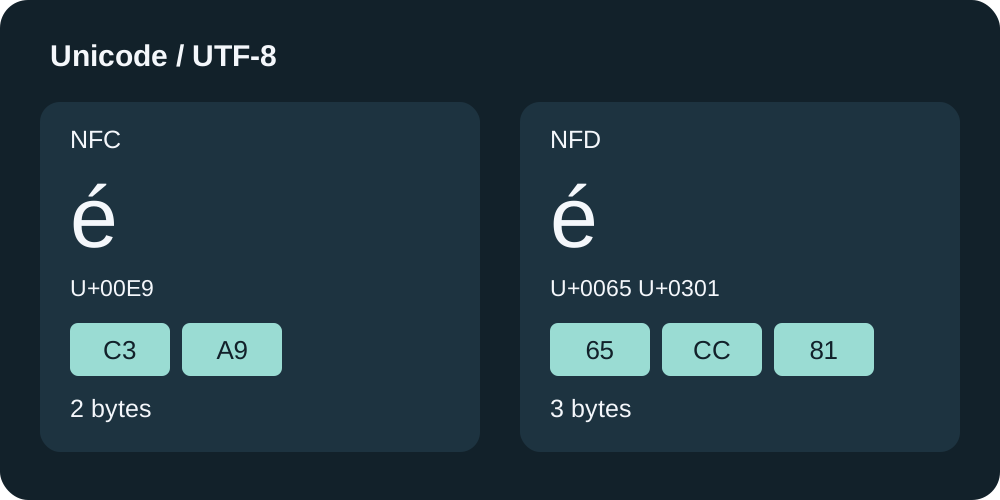
Das erste Beispiel vergleicht é als einzelnen Codepunkt U+00E9 mit der Folge aus U+0065 (e) und U+0301 (kombinierendem Akzent). Die zweite Darstellung besteht aus zwei Codepunkten. Da Schriftart und Darstellung die sichtbare Form beeinflussen können, nennen wir die ursprünglichen Folgen ausdrücklich. Unicode betrachtet beide Darstellungen als kanonisch äquivalent.
Unicode UAX #15: Kanonische Äquivalenz und Normalisierung
Anzahl der Zeichen, Bytes und Base64, bestätigt mit tatsächlichen Toolfunktionen
Am 5. Oktober 2026 haben wir die Eingaben mit den Projektfunktionen countText, base64 und digest geprüft. Die Zeichenanzahl bezeichnet die von Moyoutil gezählten Codepunkte, nicht unbedingt die von Menschen wahrgenommenen Zeichen. Die Werkzeuge wandeln diese Eingaben nicht automatisch in NFC um.
| Codepunkt | Anzahl der Zeichen | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
Die koreanischen Beispiele vergleichen eine vorkomponierte Hangul-Silbe mit einer Folge kombinierender Jamo. Die Messwerte gelten für die Eingaben in der Tabelle, nicht als feste Bytezahlen für alle koreanischen Texte oder Zeichen mit Akzent. TextEncoder verwendet UTF-8.
Hash vergleicht Eingabebytes anstelle der Bildschirmdarstellung
Die Übergabe der UTF-8-Bytes der beiden obigen é-Darstellungen an die Moyoutil SHA-256-Funktion führt zu dem folgenden Ergebnis. In diesem Fall handelt es sich um unterschiedliche Werte. Der Textmodus verfügt über keine automatische Normalisierung und der Dateimodus verwendet die Dateibytes unverändert. Gehen Sie nicht davon aus, dass der Hash eines als Text eingefügten Werts mit dem Hash der gesamten Originaldatei übereinstimmt.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
Geben Sie jeden Ausdruck separat in das Zeichenanzahl-Tool ein, um die Anzahl der Bytes zu bestimmen, und berechnen Sie dann den SHA-256 derselben Eingabe im Textmodus des SHA-Hash-Tools. Da die ursprüngliche Anordnung möglicherweise nicht reproduziert wird, wenn Sie dieselbe Form erneut auf der Tastatur eingeben, können Sie auch den Escape-Ausdruck im folgenden Code verwenden, um den Originaltext zu generieren.
NFC-Vergleich reproduzieren, aber Originaltext beibehalten
Die JavaScript-Methode normalize unterstützt NFC, NFD, NFKC und NFKD. Das Beispiel vergleicht beide é-Folgen nach ihrer Umwandlung in NFC. NFC führt eine kanonische Zerlegung und anschließend, soweit möglich, eine kanonische Zusammensetzung durch. Gleiche normalisierte Werte bedeuten nicht, dass die ursprünglichen Folgen identisch waren.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
NFKC bereinigt auch Kompatibilitätsunterschiede und ersetzt die eingekreiste Zahl ① in diesem Beispiel durch 1. Bei bedingungsloser Anwendung auf Daten, bei denen Unterscheidungen wichtig sind, kann sich der Originaltext ändern. Die Normalisierung ist auch ein von der Groß-/Kleinschreibung oder der Entfernung von Leerzeichen getrennter Vorgang.
Unicode UAX #15: Normalisierungsformat und Kompatibilitätsunterschiede
Reihenfolge der Untersuchung von Byte-Limit- und Prüfsummenfehlern
- Behalten Sie das Original bei und unterscheiden Sie zwischen Vergleichstext oder der gesamten Datei.
- Überprüfen Sie die Anzahl der UTF-8-Bytes und überprüfen Sie führende und nachfolgende Leerzeichen sowie Zeilenumbrüche separat.
- Stellen Sie sicher, dass das empfangende System das Normalisierungsformat angibt. Wenn es keine Regeln gibt, werden wir den Originaltext nicht willkürlich ändern.
- Wenn es sich bei der Normalisierung um einen vereinbarten Textvergleich handelt, wenden Sie dasselbe Format auf die Kopie an und überprüfen Sie dann die Bytes und Hashes erneut.
- Die Integritätsprüfung der Originaldatei vergleicht die Datei mit der bereitgestellten Prüfsumme, ohne sie zu bearbeiten oder zu normalisieren.
Derzeit sind die Zeichenanzahl-/Base64-/SHA-Tools von Moyoutil keine Normalisierungseditoren. Es gibt keine Schaltfläche zum automatischen Durchführen der Normalisierung. Der Code in diesem Artikel dient nur der technischen Vervielfältigung und ersetzt nicht die Einreichungsregeln eines externen Dienstes.
Häufig gestellte Fragen
Wird die Größe aller Zeichen reduziert, wenn ich zu NFC wechsle?
Nein. Die beiden Beispiele in diesem Artikel reduzieren die Anzahl der Bytes, aber dies ist nicht die Regel zur Reduzierung der Kapazität für alle Eingaben. Überprüfen Sie die tatsächliche Anzahl der Bytes nach der Konvertierung.
Sollten gleich aussehende Passwörter automatisch normalisiert werden?
Dieser Artikel legt keine Regeln für den Umgang mit Passwörtern in Authentifizierungssystemen fest. Ändern Sie den Originaltext nicht willkürlich ohne die vorgegebenen Regeln des Systems.