फ़ाइल में EF BB BF हो सकता है
Unicode में UTF-8 BOM के बाइट EF BB BF हैं। UTF-8 में यह एन्कोडिंग हस्ताक्षर है, बाइट क्रम बदलने का संकेत नहीं। उदाहरण में abc के 61 62 63 जोड़कर छह बाइट हैं। Moyoutil का फ़ाइल मोड arrayBuffer से मूल बाइट पढ़ता है; पाठ मोड TextEncoder से UTF-8 बनाता है।
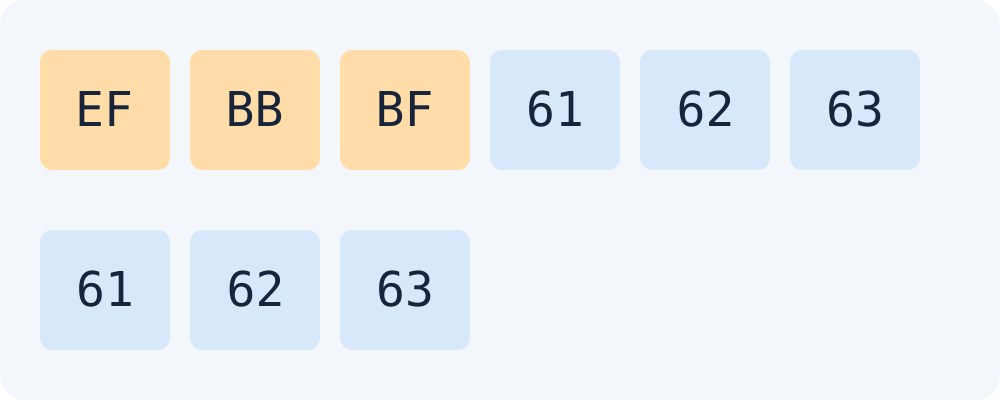
ignoreBOM: true अक्षर को बनाए रखता है
डिफ़ॉल्ट TextDecoder शुरुआती BOM हटाकर abc देता है। ignoreBOM को true करने पर BOM प्रक्रिया छोड़ दी जाती है और U+FEFF रहता है। डिफ़ॉल्ट पाठ फिर एन्कोड करने पर तीन बाइट और इस उदाहरण में मूल छह बाइट से अलग SHA-256 मिलता है। हर संपादक या कॉपी प्रक्रिया के लिए ऐसा न मानें।
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3मूल फ़ाइल का checksum जाँचने के लिए फ़ाइल मोड चुनें। केवल दिखता abc चिपकाना दूसरा इनपुट है। स्ट्रिंग में U+FEFF बचा हो तो उसके बाइट भी एन्कोड होंगे। हैश मिलाने के लिए मूल BOM न हटाएँ; एल्गोरिदम और फ़ाइल संस्करण जाँचें।
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
अक्सर पूछे जाने वाले प्रश्न
क्या बीच का U+FEFF भी हटता है?
इस उदाहरण में केवल शुरुआती BOM हटता है। बीच का U+FEFF रहता है; ignoreBOM: true शुरुआती अक्षर भी रखता है। कोड और खाली इनपुट चलाकर जाँच की गई है।