स्क्रीन पर कोड बिंदुओं की उपस्थिति और व्यवस्था भिन्न हो सकती है।
पहले उदाहरण में एक कोड पॉइंट U+00E9 वाला é और दो कोड पॉइंट U+0065 (e) तथा U+0301 (संयोजन चिह्न) वाली श्रृंखला की तुलना है। फ़ॉन्ट और रेंडरिंग के अनुसार रूप बदल सकता है, इसलिए मूल कोड पॉइंट श्रृंखलाएँ स्पष्ट दी गई हैं। Unicode में ये दोनों रूप canonically equivalent हैं।
यूनिकोड यूएक्स #15: कैनोनिकल तुल्यता और सामान्यीकरण
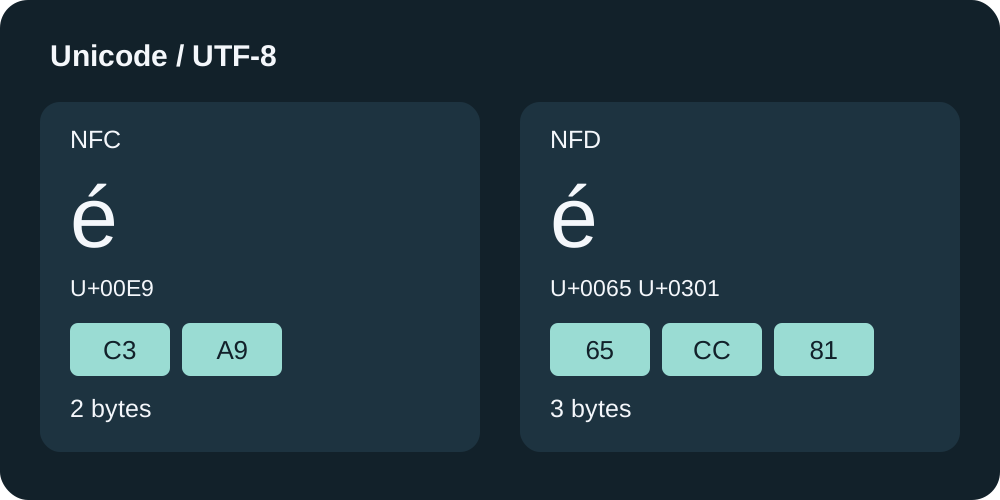
वास्तविक टूल फ़ंक्शंस के साथ वर्णों, बाइट्स और बेस64 की संख्या की पुष्टि की गई
5 अक्टूबर 2026 को प्रोजेक्ट के countText, base64 और digest फ़ंक्शन से इन इनपुट की जाँच की गई। यहाँ वर्णों की गिनती Moyoutil द्वारा गिने गए कोड पॉइंट की संख्या है, जरूरी नहीं कि व्यक्ति को दिखाई देने वाले वर्णों की संख्या हो। ये टूल इन इनपुट को अपने आप NFC में नहीं बदलते।
| कोड बिंदु | वर्णों की संख्या | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
कोरियाई उदाहरण में पहले से संयोजित Hangul अक्षर और संयोजन के लिए प्रयुक्त jamo की श्रृंखला की तुलना है। माप तालिका के इनपुट के लिए हैं; सभी कोरियाई या उच्चारण चिह्न वाले टेक्स्ट के लिए बाइट संख्या तय नहीं है। TextEncoder UTF-8 का उपयोग करता है।
हैश स्क्रीन उपस्थिति के बजाय इनपुट बाइट्स की तुलना करता है
उपरोक्त दो é अभ्यावेदन के UTF-8 बाइट्स को Moyoutil SHA-256 फ़ंक्शन में पास करने से नीचे परिणाम प्राप्त होता है। इस मामले में वे अलग-अलग मूल्य हैं। टेक्स्ट मोड में कोई स्वचालित सामान्यीकरण नहीं है, और फ़ाइल मोड फ़ाइल बाइट्स का उपयोग करता है। यह न मानें कि टेक्स्ट के रूप में चिपकाए गए मान का हैश संपूर्ण मूल फ़ाइल के हैश के समान है।
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
बाइट्स की संख्या निर्धारित करने के लिए कैरेक्टर काउंट टूल में प्रत्येक अभिव्यक्ति को अलग से दर्ज करें, फिर SHA हैश टूल के टेक्स्ट मोड में उसी इनपुट के SHA-256 की गणना करें। चूँकि यदि आप कीबोर्ड पर दोबारा वही आकृति टाइप करते हैं तो मूल व्यवस्था पुन: प्रस्तुत नहीं की जा सकती है, आप मूल पाठ उत्पन्न करने के लिए नीचे दिए गए कोड में एस्केप अभिव्यक्ति का भी उपयोग कर सकते हैं।
एनएफसी तुलना को पुन: प्रस्तुत करें, लेकिन मूल पाठ को सुरक्षित रखें
JavaScript का normalize मेथड NFC, NFD, NFKC और NFKD को समर्थन देता है। उदाहरण में é की दोनों श्रृंखलाओं को NFC में बदलकर तुलना की जाती है। NFC पहले canonical decomposition और फिर जहाँ संभव हो canonical composition करता है। सामान्यीकृत मान बराबर होने का अर्थ यह नहीं कि मूल श्रृंखलाएँ समान थीं।
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
एनएफकेसी संगतता अंतर को भी साफ करता है और इस उदाहरण में गोलाकार संख्या ① को 1 से बदल देता है। यदि डेटा पर बिना शर्त लागू किया जाता है जहां अंतर महत्वपूर्ण हैं, तो मूल पाठ बदल सकता है। सामान्यीकरण भी केस रूपांतरण या व्हाइटस्पेस हटाने से एक अलग ऑपरेशन है।
बाइट सीमा और चेकसम त्रुटियों की जांच का आदेश
- मूल को रखें और पाठ या संपूर्ण फ़ाइल की तुलना करने के बीच अंतर करें।
- यूटीएफ-8 बाइट गिनती की जांच करें और अग्रणी और अनुगामी रिक्त स्थान और लाइन ब्रेक की अलग-अलग जांच करें।
- सत्यापित करें कि प्राप्तकर्ता प्रणाली सामान्यीकरण प्रारूप निर्दिष्ट करती है। यदि कोई नियम नहीं हैं, तो हम मूल पाठ को मनमाने ढंग से नहीं बदलेंगे।
- यदि सामान्यीकरण एक सहमत पाठ तुलना है, तो कॉपी पर वही प्रारूप लागू करें और फिर बाइट्स और हैश की दोबारा जांच करें।
- मूल फ़ाइल अखंडता जांच फ़ाइल को संपादित या सामान्य किए बिना दिए गए चेकसम के विरुद्ध तुलना करती है।
वर्तमान में, मोयोटिल के कैरेक्टर काउंट/बेस64/एसएचए उपकरण सामान्यीकरण संपादक नहीं हैं। स्वचालित रूप से सामान्यीकरण करने के लिए कोई बटन नहीं है। इस आलेख में कोड केवल तकनीकी पुनरुत्पादन उद्देश्यों के लिए है और किसी बाहरी सेवा के सबमिशन नियमों को प्रतिस्थापित नहीं करता है।
अक्सर पूछे जाने वाले प्रश्न
क्या NFC में बदलने से हर टेक्स्ट की बाइट संख्या कम हो जाती है?
नहीं। इस आलेख में दो उदाहरण बाइट्स की संख्या को कम करते हैं, लेकिन यह सभी इनपुट के लिए क्षमता को कम करने का नियम नहीं है। रूपांतरण के बाद बाइट्स की वास्तविक संख्या जांचें।
क्या एक जैसे दिखने वाले पासवर्ड को स्वचालित रूप से सामान्यीकृत किया जाना चाहिए?
यह आलेख प्रमाणीकरण प्रणालियों में पासवर्ड को संभालने के लिए नियम निर्धारित नहीं करता है। सिस्टम के निर्दिष्ट नियमों के बिना मूल पाठ को मनमाने ढंग से न बदलें।