Hífens e vírgulas não dividem palavras
A implementação usa trim() nas pontas e divide com /\s+/u. Entrada vazia ou só com espaços conta como 0. Espaços, tabulações e quebras de linha separam blocos; hífens, vírgulas e apóstrofos sozinhos não. \s do JavaScript corresponde a WhiteSpace e LineTerminator da especificação.
Assim, state-of-the-art conta como 1, one,two como 1 e one, two como 2. don’t stop também tem dois blocos. ... conta como 1 mesmo sendo só pontuação; não interprete isso como palavras com significado. words é a estatística do programa no código.
countText("state-of-the-art").words // 1
countText("one,two").words          // 1
countText("one, two").words         // 2
countText("don’t stop").words       // 2
countText("...").words              // 1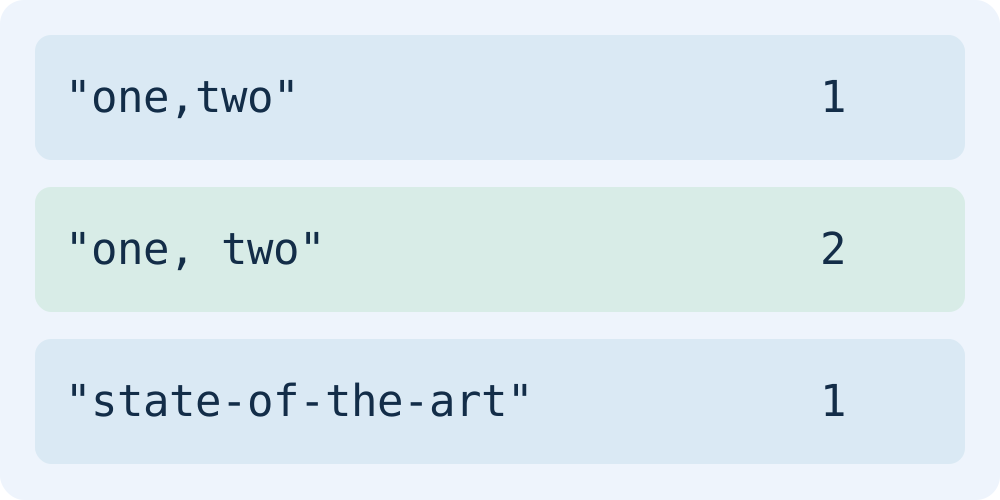
Texto sem espaços não é segmentado por idioma
你好世界 conta como 1. Isso não significa que a frase chinesa tenha uma só palavra linguística. Unicode UAX #29 explica que limites de palavras não se restringem a espaços e pontuação e que certos idiomas exigem ajustes. Moyoutil não aplica esse algoritmo nem análise por dicionário.
countText("你好世界").words // 1
countText("one  two").words // 2
countText("one\ntwo").words // 2
countText(" \t\n").words // 0
Unicode UAX #29: Word Boundaries
Cole texto no contador de caracteres e bytes para atualizar as estatísticas. Teste uma frase representativa com hífens ou quebras antes do rascunho inteiro. Se a entrega especificar um editor ou método, use-o na conferência final. Acrescentar espaços desnecessários para mudar o número altera o próprio texto.
Perguntas frequentes
Espaços repetidos ou quebras aumentam a contagem?
Separadores consecutivos formam um limite. Dois espaços entre one e two ainda dão 2; uma quebra de linha também. A mesma contagem pode ter diferentes caracteres com espaços ou bytes UTF-8.