하이픈과 쉼표는 단어를 나누지 않습니다
현재 구현은 양 끝 공백을 trim()으로 제거한 뒤 /\s+/u로 나눕니다. 빈 입력이나 공백만 있는 입력은 0입니다. 공백, 탭, 줄바꿈은 구분자가 되지만 하이픈, 쉼표, 아포스트로피만으로는 나누지 않습니다. JavaScript의 \s는 규격의 WhiteSpace와 LineTerminator에 해당합니다.
따라서 state-of-the-art는 1, one,two는 1, one, two는 2입니다. don’t stop도 두 묶음입니다. 문장부호만 있는 ...은 1로 세므로 이 결과를 의미 있는 단어의 개수로 해석하지 마세요. 아래 코드의 words는 단어 통계 값입니다.
countText("state-of-the-art").words // 1
countText("one,two").words          // 1
countText("one, two").words         // 2
countText("don’t stop").words       // 2
countText("...").words              // 1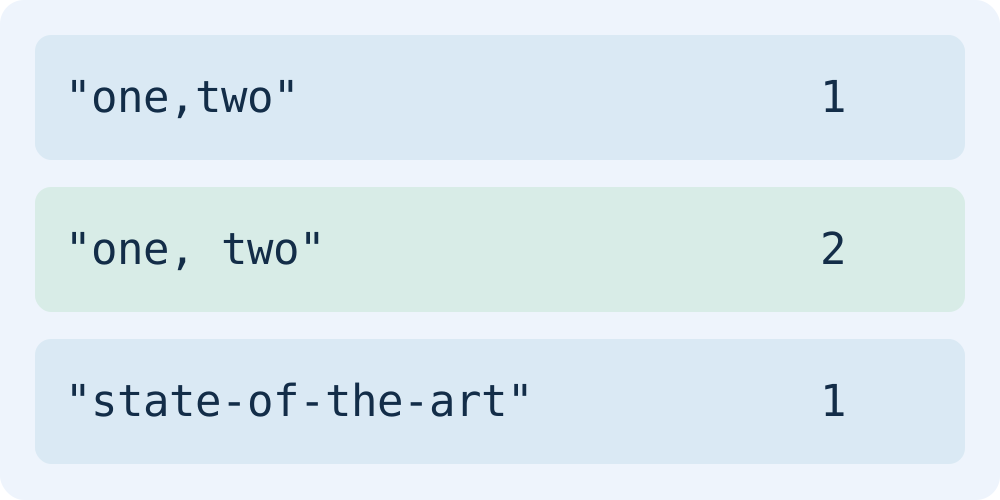
공백 없는 문장은 언어별로 분해하지 않습니다
你好世界는 이 도구에서 1입니다. 중국어 문장의 실제 단어가 하나라는 뜻이 아닙니다. Unicode UAX #29는 단어 경계가 공백과 문장부호에만 제한되지 않으며 일부 언어에는 추가 조정이 필요하다고 설명합니다. Moyoutil은 이 단어 경계 알고리즘이나 사전 기반 분석을 적용하지 않습니다.
countText("你好世界").words // 1
countText("one  two").words // 2
countText("one\ntwo").words // 2
countText(" \t\n").words // 0
Unicode UAX #29: Word Boundaries
글자 수·바이트 계산기에 문장을 붙여 넣으면 통계가 즉시 바뀝니다. 하이픈이나 줄바꿈이 있는 대표 문장을 먼저 확인하고 원고 전체를 넣으세요. 제출처가 지정한 편집기나 계산 기준이 있다면 그 결과로 최종 확인하세요. 숫자를 맞추려고 원고에 불필요한 공백을 넣으면 텍스트 자체가 바뀝니다.
자주 묻는 질문
연속 공백과 줄바꿈은 단어 수를 늘리나요?
연속 구분자는 하나의 경계로 처리합니다. one 다음에 공백 두 개와 two가 있어도 2이며, 두 항목 사이가 줄바꿈이어도 2입니다. 단어 값이 같아도 공백 포함 글자 수나 UTF-8 바이트 수는 달라질 수 있습니다.