Tampilan dan susunan titik kode pada layar mungkin berbeda-beda.
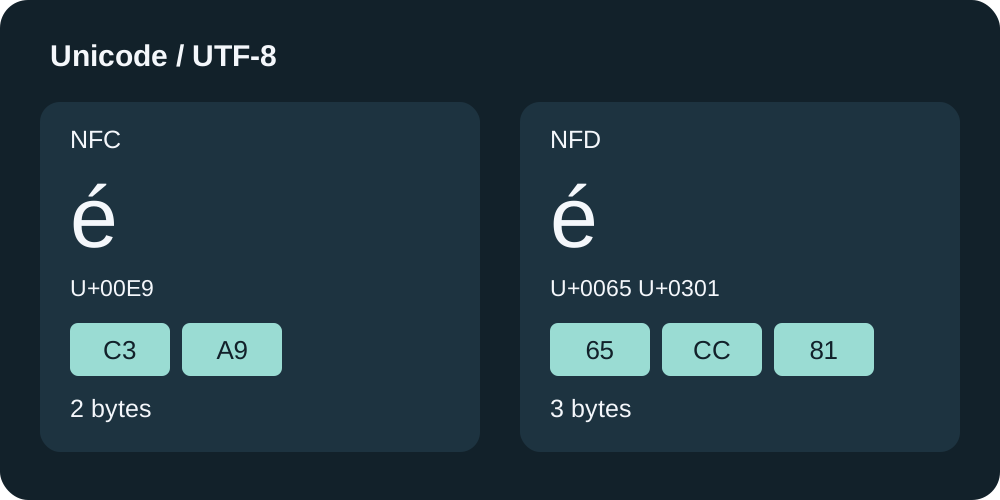
Contoh pertama membandingkan é sebagai satu code point U+00E9 dengan urutan dua code point: U+0065 (e) lalu U+0301 (aksen gabungan). Tampilan bergantung pada font dan perenderan, sehingga urutan aslinya disebutkan secara jelas. Unicode menganggap kedua representasi ini ekuivalen secara kanonik.
Unicode UAX #15: Kesetaraan dan normalisasi kanonik
Jumlah karakter, byte, dan Base64 dikonfirmasi dengan fungsi alat sebenarnya
Pada 5 Oktober 2026, kami memeriksa input ini dengan fungsi countText, base64, dan digest proyek. Jumlah karakter di sini berarti jumlah code point yang dihitung Moyoutil, bukan selalu jumlah karakter yang dilihat pembaca. Alat tidak otomatis mengubah input ini ke NFC.
| titik kode | jumlah karakter | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
Contoh Korea membandingkan suku kata Hangul yang sudah tersusun dengan urutan jamo penggabung. Pengukuran berlaku untuk input dalam tabel, bukan jumlah byte tetap untuk semua teks Korea atau karakter beraksen. TextEncoder menggunakan UTF-8.
Hash membandingkan byte input alih-alih tampilan layar
Meneruskan byte UTF-8 dari dua representasi é di atas ke fungsi Moyoutil SHA-256 menghasilkan hasil di bawah ini. Dalam hal ini nilainya berbeda. Mode teks tidak memiliki normalisasi otomatis, dan mode file menggunakan byte file apa adanya. Jangan berasumsi bahwa hash dari nilai yang ditempelkan sebagai teks sama dengan hash dari seluruh file asli.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
Masukkan setiap ekspresi secara terpisah ke dalam alat Penghitungan Karakter untuk menentukan jumlah byte, lalu hitung SHA-256 dari masukan yang sama dalam mode teks alat Hash SHA. Karena susunan aslinya mungkin tidak dapat direproduksi jika Anda mengetikkan bentuk yang sama lagi pada keyboard, Anda juga dapat menggunakan ekspresi escape pada kode di bawah ini untuk menghasilkan teks asli.
Mereproduksi perbandingan NFC, namun mempertahankan teks aslinya
Metode normalize JavaScript mendukung NFC, NFD, NFKC, dan NFKD. Contoh ini membandingkan kedua urutan é setelah masing-masing diubah ke NFC. NFC melakukan dekomposisi kanonik, lalu komposisi kanonik jika memungkinkan. Hasil normalisasi yang sama tidak berarti urutan aslinya identik.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
NFKC juga membersihkan perbedaan kompatibilitas dan mengganti angka yang dilingkari ① dalam contoh ini dengan 1. Jika diterapkan tanpa syarat pada data yang mengutamakan perbedaan, teks asli dapat berubah. Normalisasi juga merupakan operasi terpisah dari konversi kasus atau penghapusan spasi.
Unicode UAX #15: Format normalisasi dan perbedaan kompatibilitas
Urutan penyelidikan batas byte dan kesalahan checksum
- Simpan yang asli dan bedakan antara membandingkan teks atau keseluruhan file.
- Periksa jumlah byte UTF-8 dan periksa spasi awal dan akhir serta jeda baris secara terpisah.
- Verifikasi bahwa sistem penerima menentukan format normalisasi. Jika tidak ada aturan, kami tidak akan mengubah teks asli secara sembarangan.
- Jika normalisasi adalah perbandingan teks yang disepakati, terapkan format yang sama pada salinan lalu periksa kembali byte dan hashnya.
- Pemeriksaan integritas file asli membandingkan file dengan checksum yang disediakan tanpa mengedit atau menormalkannya.
Saat ini, alat Penghitungan Karakter/Base64/SHA Moyoutil bukanlah editor normalisasi. Tidak ada tombol untuk melakukan normalisasi secara otomatis. Kode dalam artikel ini hanya untuk tujuan reproduksi teknis dan tidak menggantikan aturan penyerahan layanan eksternal apa pun.
Pertanyaan yang Sering Diajukan
Jika saya mengganti ke NFC, apakah ukuran semua karakter akan berkurang?
Tidak. Dua contoh dalam artikel ini mengurangi jumlah byte, namun ini bukan aturan untuk mengurangi kapasitas semua input. Periksa jumlah byte sebenarnya setelah konversi.
Haruskah kata sandi yang terlihat sama dinormalisasi secara otomatis?
Artikel ini tidak menetapkan aturan untuk menangani kata sandi dalam sistem otentikasi. Jangan sembarangan mengubah teks asli tanpa aturan sistem yang jelas.