La apariencia y disposición de los puntos de código en la pantalla pueden variar.
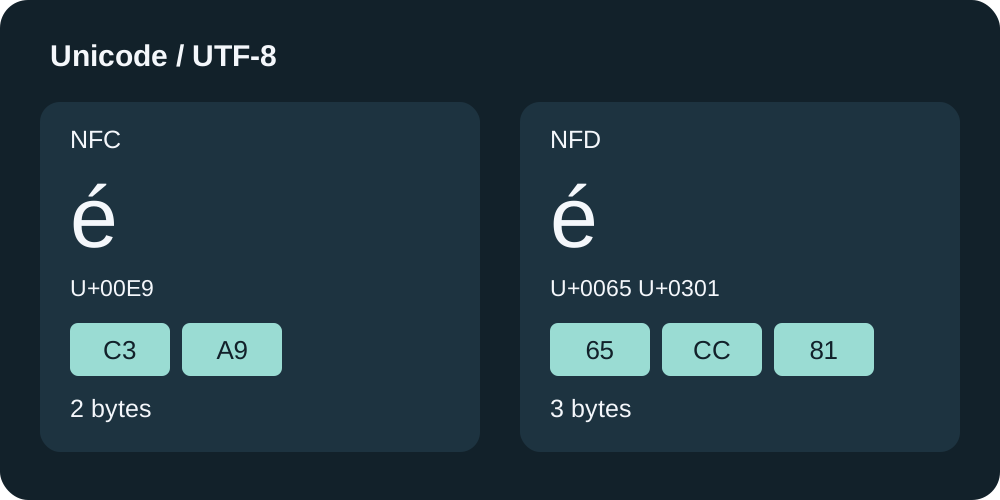
El primer ejemplo compara é como un único punto de código U+00E9 con la secuencia de dos puntos de código U+0065 (e) y U+0301 (acento combinante). La apariencia depende de la fuente y del entorno de representación; por eso identificamos las secuencias originales. Unicode considera estas representaciones canónicamente equivalentes.
Unicode UAX #15: Equivalencia canónica y normalización
Número de caracteres, bytes y Base64 confirmados con funciones reales de la herramienta
El 5 de octubre de 2026 comprobamos estas entradas con las funciones countText, base64 y digest del proyecto. El recuento indica los puntos de código que cuenta Moyoutil, no necesariamente los caracteres que percibe una persona. Las herramientas no convierten automáticamente estas entradas a NFC.
| punto de código | número de caracteres | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
Los ejemplos coreanos comparan una sílaba Hangul precompuesta con una secuencia de jamo combinantes. Son mediciones de las entradas de la tabla, no cantidades de bytes fijas para todo el texto coreano o acentuado. TextEncoder utiliza UTF-8.
Hash compara los bytes de entrada en lugar de la apariencia de la pantalla
Pasar los bytes UTF-8 de las dos representaciones é anteriores a la función Moyoutil SHA-256 produce el siguiente resultado. En este caso son valores diferentes. El modo de texto no tiene normalización automática y el modo de archivo utiliza bytes de archivo tal cual. No asuma que el hash de un valor pegado como texto es el mismo que el hash de todo el archivo original.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
Ingrese cada expresión por separado en la herramienta Recuento de caracteres para determinar el número de bytes, luego calcule el SHA-256 de la misma entrada en el modo de texto de la herramienta SHA Hash. Dado que es posible que el arreglo original no se reproduzca si escribe la misma forma nuevamente en el teclado, también puede usar la expresión de escape en el código siguiente para generar el texto original.
Reproduzca la comparación NFC, pero conserve el texto original
El método normalize de JavaScript admite NFC, NFD, NFKC y NFKD. El ejemplo compara las dos secuencias de é después de convertir ambas a NFC. NFC aplica descomposición canónica y después composición canónica donde es posible. Que los resultados coincidan no significa que las secuencias originales fueran idénticas.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
NFKC también limpia las diferencias de compatibilidad y reemplaza el número ① encerrado en un círculo en este ejemplo con 1. Si se aplica incondicionalmente a datos donde las distinciones son importantes, el texto original puede cambiar. La normalización también es una operación separada de la conversión de casos o la eliminación de espacios en blanco.
Unicode UAX #15: Formato de normalización y diferencias de compatibilidad
Orden de investigación de errores de límite de bytes y suma de comprobación
- Conservar el original y distinguir entre comparar texto o el archivo completo.
- Verifique el recuento de bytes UTF-8 y verifique los espacios iniciales y finales y los saltos de línea por separado.
- Verificar que el sistema receptor especifique el formato de normalización. Si no hay reglas, no cambiaremos el texto original arbitrariamente.
- Si la normalización es una comparación de texto acordada, aplique el mismo formato a la copia y luego verifique los bytes y hashes nuevamente.
- La verificación de integridad del archivo original compara el archivo con la suma de verificación proporcionada sin editarlo ni normalizarlo.
Actualmente, las herramientas Character Count/Base64/SHA de Moyoutil no son editores de normalización. No hay ningún botón para realizar la normalización automáticamente. El código de este artículo tiene únicamente fines de reproducción técnica y no reemplaza las reglas de envío de ningún servicio externo.
Preguntas frecuentes
Si cambio a NFC, ¿se reducirá el tamaño de todos los caracteres?
No. Los dos ejemplos de este artículo reducen el número de bytes, pero esta no es la regla para reducir la capacidad de todas las entradas. Verifique el número real de bytes después de la conversión.
¿Deberían normalizarse automáticamente las contraseñas que tienen el mismo aspecto?
Este artículo no establece reglas para el manejo de contraseñas en sistemas de autenticación. No cambie arbitrariamente el texto original sin las reglas especificadas del sistema.