A aparência e a disposição dos pontos de código na tela podem variar.
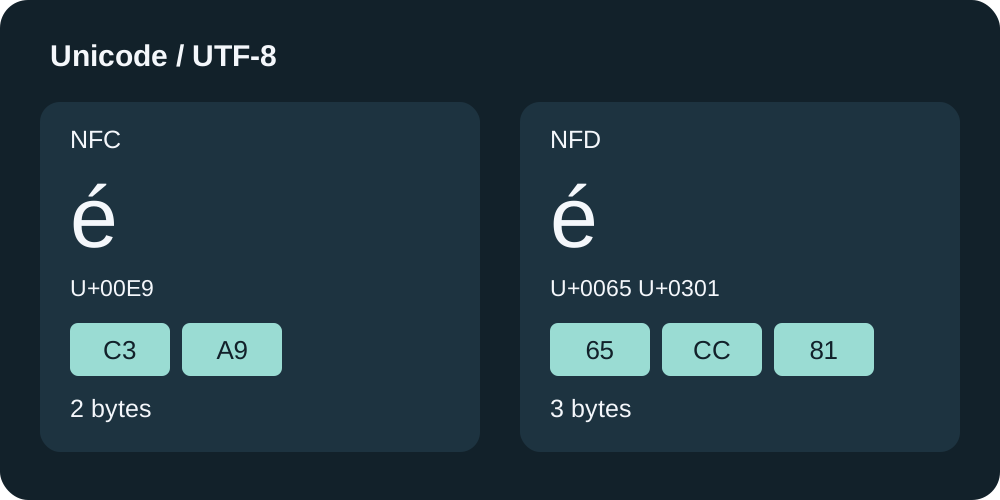
O primeiro exemplo compara é como um único ponto de código U+00E9 com a sequência de dois pontos de código U+0065 (e) e U+0301 (acento combinante). A aparência depende da fonte e do ambiente de renderização; por isso identificamos as sequências originais. O Unicode considera estas representações canonicamente equivalentes.
Unicode UAX #15: Equivalência canônica e normalização
Número de caracteres, bytes e Base64 confirmados com funções reais da ferramenta
Em 5 de outubro de 2026, verificámos estas entradas com as funções countText, base64 e digest do projeto. A contagem representa os pontos de código contados pelo Moyoutil, não necessariamente os caracteres percebidos por uma pessoa. As ferramentas não convertem automaticamente estas entradas para NFC.
| ponto de código | número de caracteres | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
Os exemplos coreanos comparam uma sílaba Hangul pré-composta com uma sequência de jamo combinantes. São medições das entradas da tabela, não quantidades fixas de bytes para todo o texto coreano ou acentuado. TextEncoder usa UTF-8.
Hash compara bytes de entrada em vez da aparência da tela
Passar os bytes UTF-8 das duas representações é acima para a função Moyoutil SHA-256 produz o resultado abaixo. Neste caso são valores diferentes. O modo de texto não tem normalização automática e o modo de arquivo usa bytes de arquivo como estão. Não presuma que o hash de um valor colado como texto é igual ao hash de todo o arquivo original.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
Insira cada expressão separadamente na ferramenta Character Count para determinar o número de bytes e, em seguida, calcule o SHA-256 da mesma entrada no modo de texto da ferramenta SHA Hash. Como o arranjo original pode não ser reproduzido se você digitar a mesma forma novamente no teclado, você também pode usar a expressão de escape no código abaixo para gerar o texto original.
Reproduza a comparação NFC, mas preserve o texto original
O método normalize do JavaScript suporta NFC, NFD, NFKC e NFKD. O exemplo compara as duas sequências de é depois de converter ambas para NFC. NFC aplica decomposição canónica e depois composição canónica quando possível. Resultados iguais não significam que as sequências originais eram idênticas.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
O NFKC também limpa as diferenças de compatibilidade e substitui o número circulado ① neste exemplo por 1. Se aplicado incondicionalmente a dados onde as distinções são importantes, o texto original pode mudar. A normalização também é uma operação separada da conversão de maiúsculas e minúsculas ou da remoção de espaços em branco.
Unicode UAX #15: Formato de normalização e diferenças de compatibilidade
Ordem de investigação de limite de bytes e erros de soma de verificação
- Mantenha o original e diferencie entre comparar o texto ou o arquivo inteiro.
- Verifique a contagem de bytes UTF-8 e verifique os espaços iniciais e finais e as quebras de linha separadamente.
- Verifique se o sistema receptor especifica o formato de normalização. Se não houver regras, não alteraremos arbitrariamente o texto original.
- Se a normalização for uma comparação de texto acordada, aplique o mesmo formato à cópia e depois verifique os bytes e hashes novamente.
- A verificação de integridade do arquivo original compara o arquivo com a soma de verificação fornecida sem editá-lo ou normalizá-lo.
Atualmente, as ferramentas Character Count/Base64/SHA da Moyoutil não são editores de normalização. Não há botão para realizar a normalização automaticamente. O código deste artigo serve apenas para fins de reprodução técnica e não substitui as regras de submissão de qualquer serviço externo.
Perguntas frequentes
Se eu mudar para NFC, o tamanho de todos os caracteres será reduzido?
Não. Os dois exemplos deste artigo reduzem o número de bytes, mas esta não é a regra para reduzir a capacidade de todas as entradas. Verifique o número real de bytes após a conversão.
As senhas com a mesma aparência devem ser normalizadas automaticamente?
Este artigo não estabelece regras para o tratamento de senhas em sistemas de autenticação. Não altere arbitrariamente o texto original sem as regras especificadas do sistema.