L'apparence et la disposition des points de code sur l'écran peuvent varier.
Le premier exemple compare é sous la forme d’un seul point de code U+00E9 avec la séquence de deux points de code U+0065 (e) et U+0301 (accent combinant). L’apparence dépend de la police et du rendu ; nous identifions donc les séquences originales. Unicode considère ces représentations comme canoniquement équivalentes.
Unicode UAX #15 : équivalence canonique et normalisation
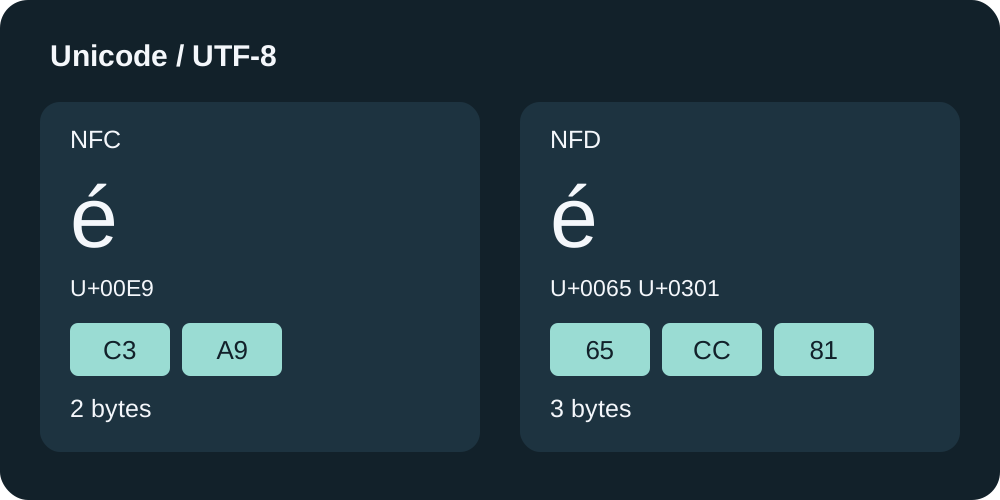
Nombre de caractères, d'octets et Base64 confirmés avec les fonctions réelles de l'outil
Le 5 octobre 2026, nous avons vérifié ces entrées avec les fonctions countText, base64 et digest du projet. Le nombre de caractères correspond aux points de code comptés par Moyoutil, pas nécessairement aux caractères perçus par une personne. Les outils ne convertissent pas automatiquement ces entrées en NFC.
| point de code | nombre de caractères | UTF-8 bytes | Base64 |
|---|---|---|---|
U+00E9 | 1 | 2 | w6k= |
U+0065 U+0301 | 2 | 3 | ZcyB |
U+AC00 | 1 | 3 | 6rCA |
U+1100 U+1161 | 2 | 6 | 4YSA4YWh |
Les exemples coréens comparent une syllabe Hangul précomposée avec une séquence de jamo combinants. Ces mesures concernent les entrées du tableau, pas un nombre fixe d’octets pour tout texte coréen ou accentué. TextEncoder utilise UTF-8.
Le hachage compare les octets d'entrée au lieu de l'apparence de l'écran
Passer les octets UTF-8 des deux représentations é ci-dessus à la fonction Moyoutil SHA-256 produit le résultat ci-dessous. Dans ce cas, ce sont des valeurs différentes. Le mode texte n'a pas de normalisation automatique et le mode fichier utilise les octets du fichier tels quels. Ne présumez pas que le hachage d'une valeur collée sous forme de texte est le même que le hachage de l'intégralité du fichier d'origine.
U+00E9
4a99557e4033c3539de2eb65472017cad5f9557f7a0625a09f1c3f6e2ba69c4c

U+0065 U+0301
bf12767b0f2a56b2190075bae8169f656e3ce8d6357d4aff184bc6c7ea48f9f6
Saisissez chaque expression séparément dans l'outil Nombre de caractères pour déterminer le nombre d'octets, puis calculez le SHA-256 de la même entrée dans le mode texte de l'outil de hachage SHA. Étant donné que la disposition originale risque de ne pas être reproduite si vous tapez à nouveau la même forme sur le clavier, vous pouvez également utiliser l'expression d'échappement dans le code ci-dessous pour générer le texte original.
Reproduire la comparaison NFC, mais conserver le texte original
La méthode normalize de JavaScript prend en charge NFC, NFD, NFKC et NFKD. L’exemple compare les deux séquences de é après leur conversion en NFC. NFC effectue une décomposition canonique puis, lorsque c’est possible, une composition canonique. Des valeurs normalisées identiques ne signifient pas que les séquences originales étaient identiques.
const a = "\u00E9";
const b = "e\u0301";
console.log(a === b); // false
console.log(a.normalize("NFC") === b.normalize("NFC")); // true
console.log(new TextEncoder().encode(a).length); // 2
console.log(new TextEncoder().encode(b).length); // 3
ECMAScript: String.prototype.normalize
NFKC nettoie également les différences de compatibilité et remplace le chiffre ① encerclé dans cet exemple par 1. S'il est appliqué sans condition à des données où les distinctions sont importantes, le texte original peut changer. La normalisation est également une opération distincte de la conversion de casse ou de la suppression des espaces.
Unicode UAX #15 : format de normalisation et différences de compatibilité
Ordre d'investigation des erreurs de limite d'octets et de somme de contrôle
- Conservez l'original et faites la distinction entre la comparaison du texte ou celle du fichier entier.
- Vérifiez le nombre d'octets UTF-8 et vérifiez séparément les espaces de début et de fin ainsi que les sauts de ligne.
- Vérifiez que le système de réception spécifie le format de normalisation. S’il n’y a pas de règles, nous ne modifierons pas arbitrairement le texte original.
- Si la normalisation est une comparaison de texte convenue, appliquez le même format à la copie, puis vérifiez à nouveau les octets et les hachages.
- La vérification de l'intégrité du fichier d'origine compare le fichier à la somme de contrôle fournie sans le modifier ni le normaliser.
Actuellement, les outils Character Count/Base64/SHA de Moyoutil ne sont pas des éditeurs de normalisation. Il n'y a pas de bouton pour effectuer automatiquement la normalisation. Le code de cet article est uniquement destiné à des fins de reproduction technique et ne remplace pas les règles de soumission d'un service externe.
Questions fréquemment posées
Si je passe au NFC, la taille de tous les caractères sera-t-elle réduite ?
Non. Les deux exemples de cet article réduisent le nombre d'octets, mais ce n'est pas la règle pour réduire la capacité de toutes les entrées. Vérifiez le nombre réel d'octets après la conversion.
Les mots de passe qui se ressemblent doivent-ils être automatiquement normalisés ?
Cet article ne définit pas de règles pour la gestion des mots de passe dans les systèmes d'authentification. Ne modifiez pas arbitrairement le texte original sans les règles spécifiées du système.