बाइट और अक्षर अलग चरण हैं
RFC 4648 का Base64 बाइट को अक्षरों में दर्शाता है। इससे मूल डेटा टेक्स्ट या चित्र होना और टेक्स्ट एन्कोडिंग तय नहीं होते। ये छोटे टेस्ट दोनों चरण अलग करते हैं; चित्र फ़ाइलें नहीं हैं।
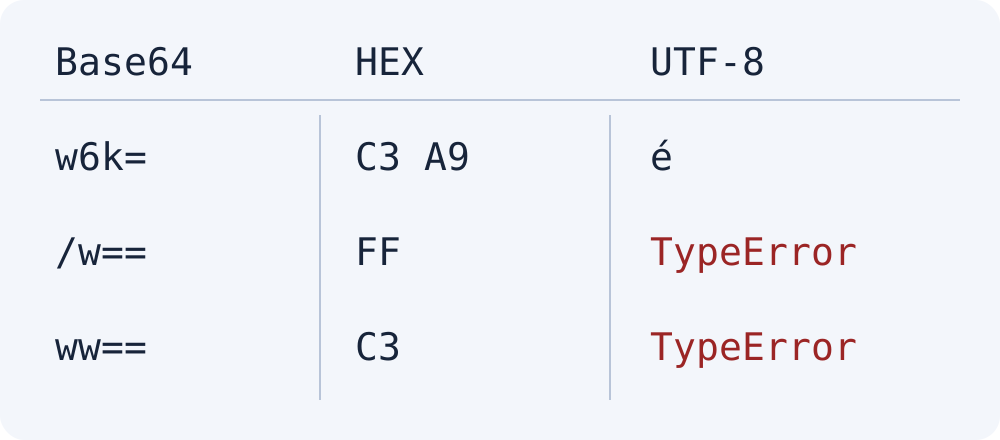
w6k= से C3 A9 मिलता है: UTF-8 में é। /w== से FF मिलता है और UTF-8 विफल होता है। ww== में केवल C3 है, जरूरी अगला बाइट नहीं। तीनों में बाइट मिले। @@@ पहले चरण में अस्वीकार हुआ।
प्रतिस्थापन और सख्त डिकोडिंग अलग हैं
WHATWG के अनुसार TextDecoder का मूल मोड replacement है; fatal: true त्रुटि पर अपवाद देता है। FF के मूल UTF-8 टेस्ट ने U+FFFD दिया। Moyoutil fatal: true के साथ त्रुटि बताता है। प्रतिस्थापन अक्षर मूल सटीक टेक्स्ट वापस नहीं लाता।
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
पहले देखें कि स्रोत UTF-8 टेक्स्ट है। चित्र और संपीड़ित फ़ाइलें इस टेक्स्ट टूल के लिए नहीं हैं। अन्य एन्कोडिंग में स्रोत की जानकारी और समर्थित टूल चाहिए। Base64 से एन्कोडिंग तय नहीं होती। Moyoutil अनुमान नहीं लगाता और Base64URL के - तथा _ समर्थित नहीं हैं।
अक्सर पूछे जाने वाले प्रश्न
क्या = बदलने से UTF-8 त्रुटि ठीक होगी?
बाइट पहले मिल चुके हों तो = बदलना समाधान नहीं है। मूल एन्कोडिंग या कटे डेटा को जाँचें। /w== से FF मिलता है, जो सही UTF-8 टेक्स्ट नहीं है।