Bytes y caracteres son pasos distintos
Base64 de RFC 4648 representa bytes con caracteres. No determina si el original era texto o imagen ni su codificación. Estos ejemplos mínimos separan los pasos; no son archivos de imagen.
w6k= restaura C3 A9: é en UTF-8. /w== restaura FF y falla en UTF-8. ww== restaura solo C3, sin el byte siguiente necesario. Los tres restauraron bytes. @@@ fue rechazado en ese primer paso.
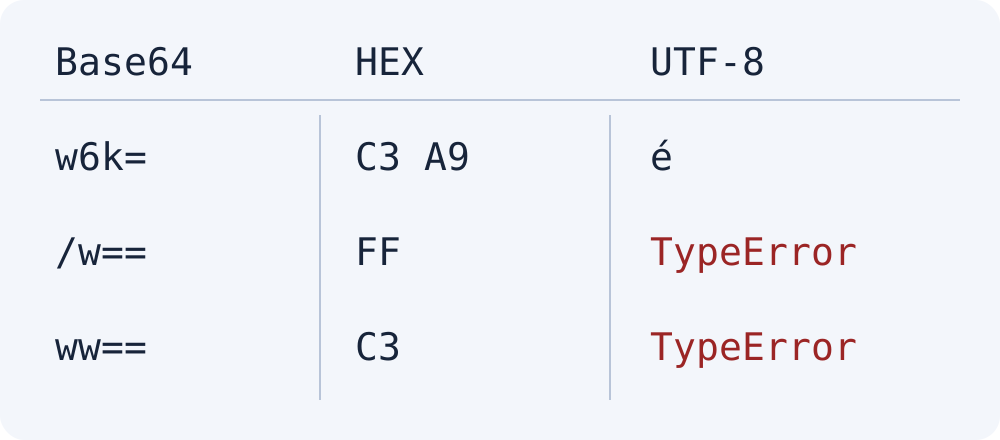
Sustitución y decodificación estricta
WHATWG define replacement como modo predeterminado de TextDecoder; fatal: true lanza una excepción ante errores. Nuestra prueba predeterminada con FF produjo U+FFFD. Moyoutil usa fatal: true y comunica un error. Obtener un carácter de sustitución no recupera el texto original exacto.
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
Confirma que el origen sea texto UTF-8. Imágenes y archivos comprimidos quedan fuera de esta herramienta textual. Para otra codificación, consulta el sistema original y usa una herramienta compatible. Base64 no identifica la codificación. Moyoutil no la adivina ni admite - y _ de Base64URL.
Preguntas frecuentes
¿Cambiar = arregla el error UTF-8?
Si los bytes ya se restauraron, cambiar = arbitrariamente no lo resuelve. Revisa la codificación o datos truncados. /w== restaura FF, pero no es texto UTF-8 válido.