Octets et caractères sont deux étapes
Base64 du RFC 4648 représente des octets par des caractères. Il ne détermine ni texte ou image ni encodage du texte. Ces tests minimaux séparent les étapes ; ce ne sont pas des fichiers image.
w6k= donne C3 A9 : é en UTF-8. /w== donne FF et échoue en UTF-8. ww== donne seulement C3, sans l’octet suivant nécessaire. Les trois ont restauré les octets. @@@ a été rejeté à cette première étape.
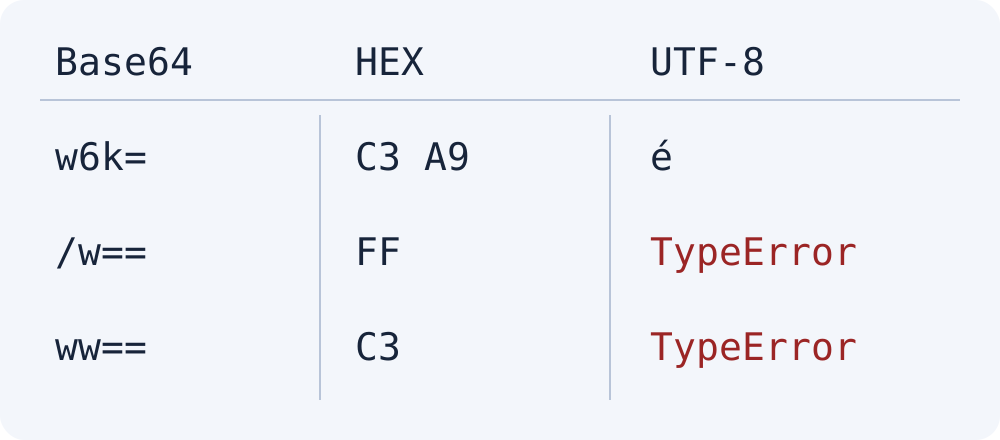
Remplacement et décodage strict diffèrent
WHATWG définit replacement comme mode par défaut de TextDecoder ; fatal: true lève une exception en cas d’erreur. Notre test par défaut avec FF a produit U+FFFD. Moyoutil utilise fatal: true et signale une erreur. Un caractère de remplacement ne restaure pas le texte original exact.
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
Vérifiez d’abord que la source est du texte UTF-8. Images et fichiers compressés sont hors du champ de cet outil textuel. Pour un autre encodage, consultez le système source et utilisez un outil adapté. Base64 ne détermine pas l’encodage. Moyoutil ne le devine pas et ne prend pas en charge - et _ de Base64URL.
Questions fréquemment posées
Modifier = corrige-t-il une erreur UTF-8 ?
Si les octets sont déjà restaurés, modifier = arbitrairement n’aide pas. Vérifiez l’encodage ou les données tronquées. /w== restaure FF, qui n’est pas du texte UTF-8 valide.