바이트 복원과 문자 해석은 별개입니다
RFC 4648의 Base64는 바이트 데이터를 문자로 표현하는 방식입니다. 원본이 텍스트인지 이미지인지, 텍스트가 어떤 인코딩인지까지 정해 주지는 않습니다. 아래 값은 실제 파일을 흉내 낸 것이 아니라 두 단계를 구분하기 위한 최소 테스트 입력입니다.
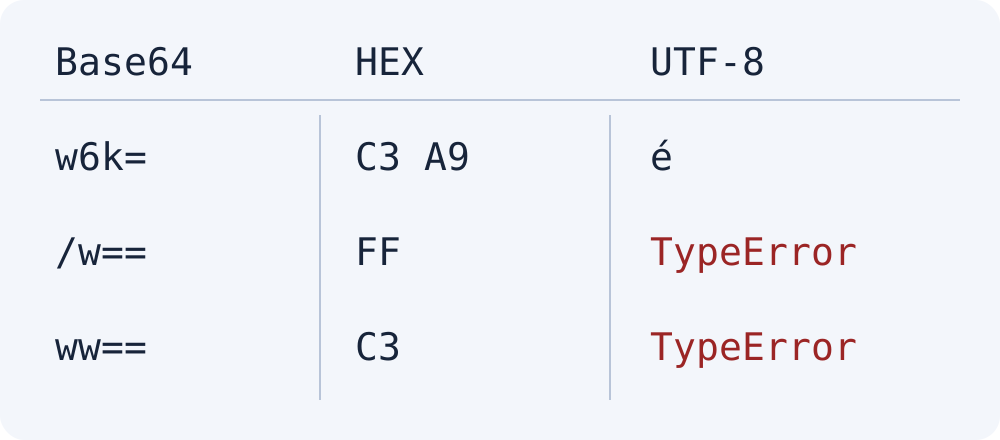
w6k=는 C3 A9 바이트로 복원되고 UTF-8에서 é입니다. /w==는 FF 한 바이트로 복원되지만 UTF-8 오류입니다. ww==는 C3만 남아 필요한 뒤 바이트가 없어 오류입니다. 세 값 모두 바이트 복원은 성공했습니다. @@@는 바이트 복원 단계에서 거부되었습니다.
깨진 문자를 표시하는 것과 오류로 중단하는 것
WHATWG Encoding Standard에서 TextDecoder의 기본 오류 처리는 replacement이고 fatal: true는 디코딩 오류 시 예외를 던집니다. FF를 기본 UTF-8 디코더에 넣은 테스트에서는 U+FFFD 대체 문자가 나왔습니다. Moyoutil은 fatal: true를 사용해 이 입력을 오류로 안내합니다. 예외를 숨겨 대체 문자를 얻어도 원본 바이트의 정확한 텍스트가 복구된 것은 아닙니다.
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
먼저 원본 데이터가 UTF-8 텍스트인지 확인하세요. 이미지나 압축 파일이라면 이 텍스트 도구의 대상이 아닙니다. 다른 문자 인코딩의 텍스트라면 원본 시스템의 인코딩 정보를 확인하고 그 인코딩을 지원하는 도구에서 처리하세요. Base64만 보고 인코딩을 확정할 수는 없습니다. Moyoutil은 다른 인코딩을 자동 추정하지 않으며 Base64URL의 -와 _도 지원하지 않습니다.
자주 묻는 질문
패딩 =을 바꾸면 UTF-8 오류가 해결되나요?
바이트 복원이 이미 성공했다면 =을 임의로 바꾸는 것은 해결책이 아닙니다. 원본 인코딩이나 잘린 데이터 여부를 확인하세요. 예제 /w==는 올바른 바이트 FF를 복원했지만 UTF-8 텍스트로는 읽을 수 없습니다.