Bytes und Zeichen sind getrennte Schritte
RFC 4648 Base64 stellt Bytes durch Zeichen dar. Es bestimmt weder Text oder Bild noch die Textcodierung. Diese minimalen Tests trennen die Schritte; es sind keine Bilddateien.
w6k= ergibt C3 A9: é in UTF-8. /w== ergibt FF und scheitert bei UTF-8. ww== ergibt nur C3 ohne nötiges Folgebyte. Alle drei wurden zu Bytes decodiert. @@@ wurde bereits dort abgewiesen.
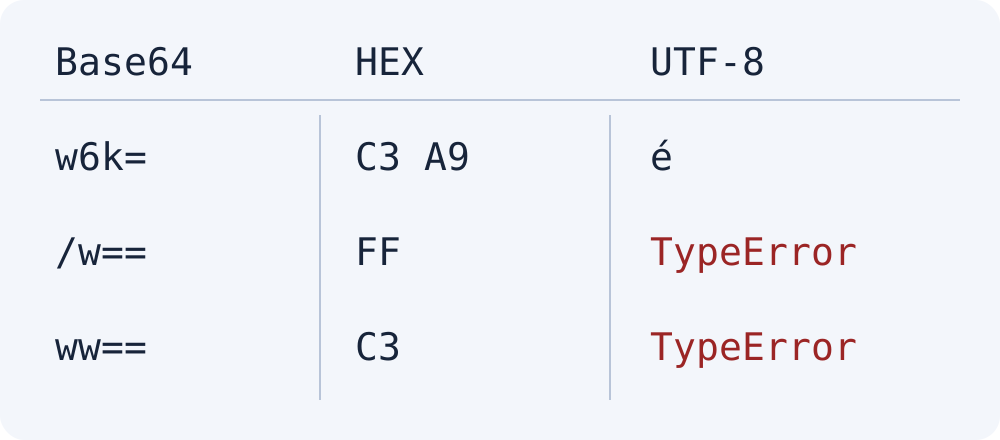
Ersetzen und strikte Decodierung unterscheiden sich
WHATWG definiert replacement als TextDecoder-Standardmodus; fatal: true wirft bei Decodierfehlern eine Ausnahme. Unser Standardtest mit FF ergab U+FFFD. Moyoutil verwendet fatal: true und meldet einen Fehler. Ein Ersatzzeichen stellt den genauen Originaltext nicht wieder her.
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
Prüfe zunächst, ob die Quelle UTF-8-Text ist. Bilder und komprimierte Dateien gehören nicht in dieses Textwerkzeug. Bei anderer Codierung prüfe das Quellsystem und nutze ein passendes Werkzeug. Base64 bestimmt die Codierung nicht. Moyoutil rät sie nicht und unterstützt kein Base64URL mit - und _.
Häufig gestellte Fragen
Behebt geändertes = einen UTF-8-Fehler?
Sind die Bytes bereits decodiert, hilft beliebiges Ändern von = nicht. Prüfe Quellcodierung oder abgeschnittene Daten. /w== ergibt FF, aber keinen gültigen UTF-8-Text.