バイト復元と文字の解釈は別の段階
RFC 4648のBase64はバイトを文字で表現します。元がテキストか画像か、文字の符号化方式は決めません。以下は二段階を分ける最小テストで、画像ファイルの例ではありません。
w6k=はC3 A9になりUTF-8ではéです。/w==はFFになりUTF-8エラーです。ww==はC3だけで後続バイトが不足します。三つともバイト復元には成功しました。@@@はバイト復元で拒否されました。
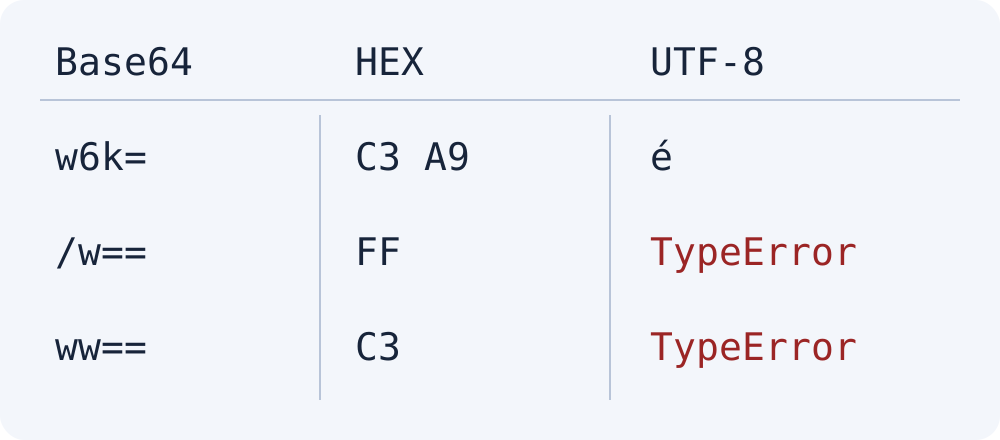
置換文字と厳密な復号は異なる
WHATWG仕様ではTextDecoderの既定はreplacementで、fatal: trueは復号エラーで例外を出します。FFの既定UTF-8テストはU+FFFDを出しました。Moyoutilはfatal: trueでエラー表示します。置換文字を出しても元の正確な文字は復元されません。
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
元がUTF-8テキストか確認してください。画像や圧縮ファイルはこのツールの対象外です。別の符号化なら元システムの情報を確認し対応ツールで処理します。Base64だけでは符号化を確定できません。Moyoutilは別の符号化を推定せず、Base64URLの-と_も非対応です。
よくある質問
=を変えるとUTF-8エラーは直りますか?
バイト復元が成功した場合、=の任意変更は解決策ではありません。元の符号化や欠落を確認してください。/w==はFFを復元しますがUTF-8として読めません。