Bytes e caracteres são etapas distintas
Base64 do RFC 4648 representa bytes com caracteres. Não determina se o original é texto ou imagem nem sua codificação. Estes testes mínimos separam as etapas; não são arquivos de imagem.
w6k= restaura C3 A9: é em UTF-8. /w== restaura FF e falha em UTF-8. ww== restaura apenas C3, sem o byte seguinte necessário. Os três restauraram bytes. @@@ foi rejeitado nessa primeira etapa.
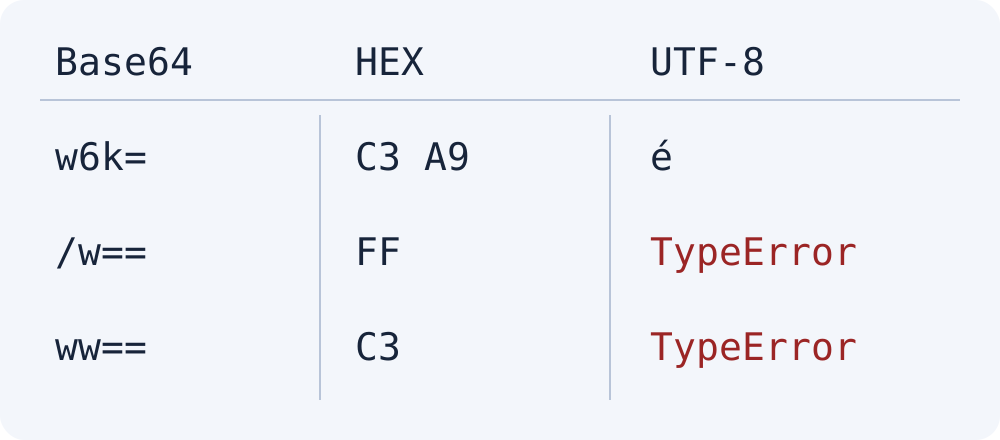
Substituição e decodificação estrita
WHATWG define replacement como modo padrão do TextDecoder; fatal: true lança exceção em erros. Nosso teste padrão com FF produziu U+FFFD. Moyoutil usa fatal: true e informa erro. Obter um caractere substituto não recupera o texto original exato.
const bytes = Uint8Array.from(atob('/w=='), c => c.charCodeAt(0));
// bytes: [255] = FF
new TextDecoder('utf-8').decode(bytes); // U+FFFD
new TextDecoder('utf-8', {fatal: true}).decode(bytes); // TypeError
Confirme se a origem é texto UTF-8. Imagens e arquivos compactados ficam fora desta ferramenta textual. Para outra codificação, consulte o sistema original e use uma ferramenta compatível. Base64 não identifica a codificação. Moyoutil não a adivinha nem suporta - e _ de Base64URL.
Perguntas frequentes
Alterar = resolve erro UTF-8?
Se os bytes já foram restaurados, alterar = arbitrariamente não resolve. Verifique a codificação ou dados truncados. /w== restaura FF, mas não é texto UTF-8 válido.