Berkas dapat menyertakan EF BB BF
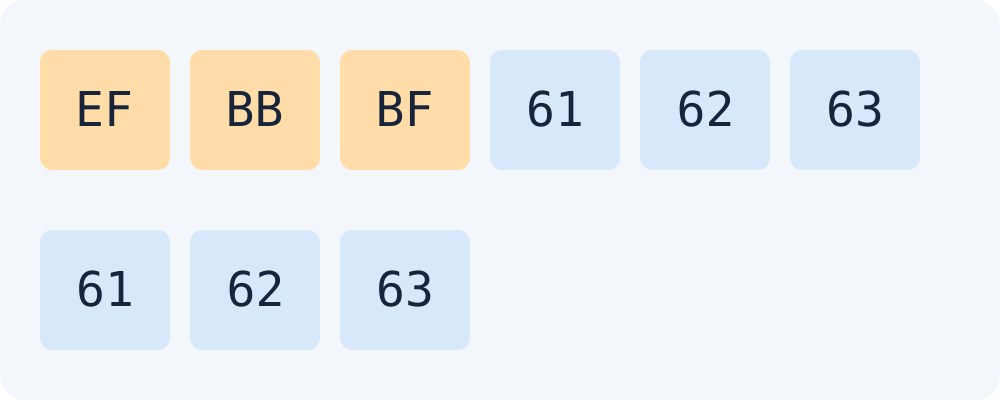
Unicode mencatat EF BB BF sebagai BOM UTF-8. Ini tanda pengodean, bukan pengubah urutan byte. Contoh menambahkan abc, 61 62 63, menjadi enam byte. Mode berkas Moyoutil membaca byte asli dengan arrayBuffer; mode teks memakai TextEncoder untuk UTF-8.
ignoreBOM: true mempertahankan karakter
TextDecoder secara bawaan menghilangkan BOM awal dan menghasilkan abc. ignoreBOM: true melewati penanganan BOM sehingga U+FEFF tetap ada. Pengodean ulang hasil bawaan memberi tiga byte; SHA-256 contoh ini berbeda dari enam byte asli. Jangan menganggap semua editor atau proses penyalinan sama.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3Untuk membandingkan checksum berkas asli, gunakan mode berkas. Menempel hanya abc berarti input berbeda. Jika U+FEFF tetap dalam string, byte-nya ikut dikodekan. Jangan hapus BOM asli hanya agar hash cocok; periksa algoritme dan versi berkas.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
Pertanyaan yang Sering Diajukan
Apakah U+FEFF di tengah dihapus?
Contoh ini hanya menghilangkan BOM awal. U+FEFF internal tetap ada; ignoreBOM: true juga menyimpan karakter awal. Kode dan input kosong dijalankan untuk memeriksanya.