ファイルにはEF BB BFが含まれる場合があります
Unicode文書でUTF-8 BOMはEF BB BFです。UTF-8ではバイト順切替ではなく符号化の署名です。例はこの3バイトにabcの61 62 63を付けた6バイトです。MoyoutilのファイルモードはarrayBufferで元のバイトを読み、テキストモードはTextEncoderでUTF-8にします。
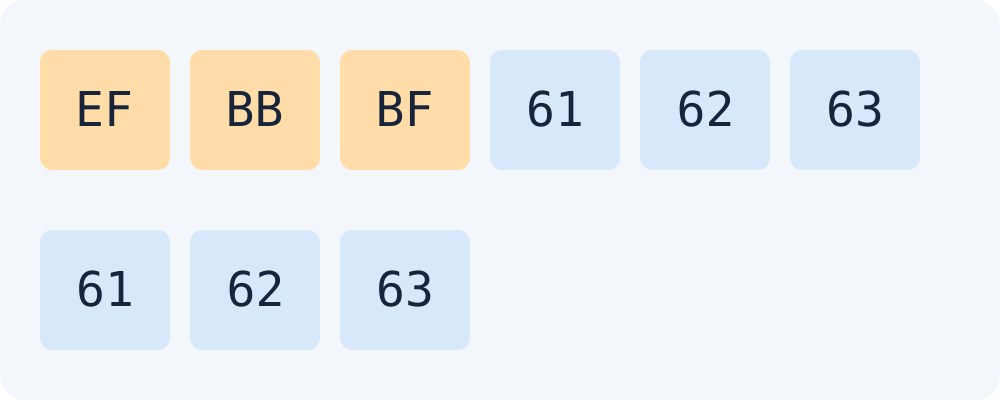
ignoreBOM: trueでは文字が残ります
既定のTextDecoderは先頭BOMを出力から除き、この例ではabcになります。ignoreBOMをtrueにするとBOM処理を省略しU+FEFFが残ります。既定出力の再エンコードは3バイトで、この例のSHA-256は元の6バイトと異なります。すべての編集ソフトやコピー操作に一般化しないでください。
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3元ファイルのチェックサム比較にはMoyoutilのファイルモードを使います。見えるabcだけの貼り付けは別の入力です。文字列にU+FEFFが残ればそのバイトもエンコードされます。照合のために元のBOMを勝手に削除せず、アルゴリズムと版を確認してください。
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
よくある質問
途中のU+FEFFも除去されますか。
この例では先頭だけを除き、途中のU+FEFFは残ります。ignoreBOM: trueなら先頭も残ります。下のコードと空入力を実行して確認しました。