Le fichier peut inclure EF BB BF
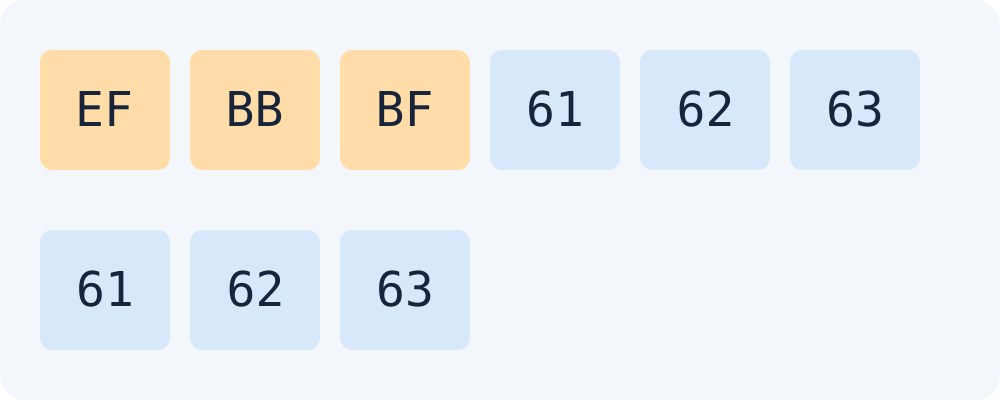
Unicode indique EF BB BF pour le BOM UTF-8. C’est une signature d’encodage, pas un changement d’ordre des octets. Notre exemple ajoute abc, 61 62 63, pour former six octets. Le mode fichier lit les octets originaux avec arrayBuffer ; le mode texte utilise TextEncoder en UTF-8.
ignoreBOM: true conserve le caractère
Par défaut, TextDecoder omet le BOM initial et donne abc. ignoreBOM: true désactive ce traitement, laissant U+FEFF. Réencoder la sortie par défaut donne trois octets ; son SHA-256 diffère ici de l’original de six octets. Ne généralisez pas à tous les éditeurs ou processus de copie.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3Pour comparer le checksum original, utilisez le mode fichier. Coller seulement abc correspond à une autre entrée. Si U+FEFF reste dans la chaîne, ses octets sont encodés. Ne retirez pas le BOM original pour forcer la concordance : vérifiez l’algorithme et la version.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
Questions fréquemment posées
U+FEFF au milieu est-il supprimé ?
Cet exemple omet seulement le BOM initial. Un U+FEFF interne reste ; ignoreBOM: true conserve aussi le caractère initial. Nous avons exécuté le code et l’entrée vide pour vérifier.