O arquivo pode incluir EF BB BF
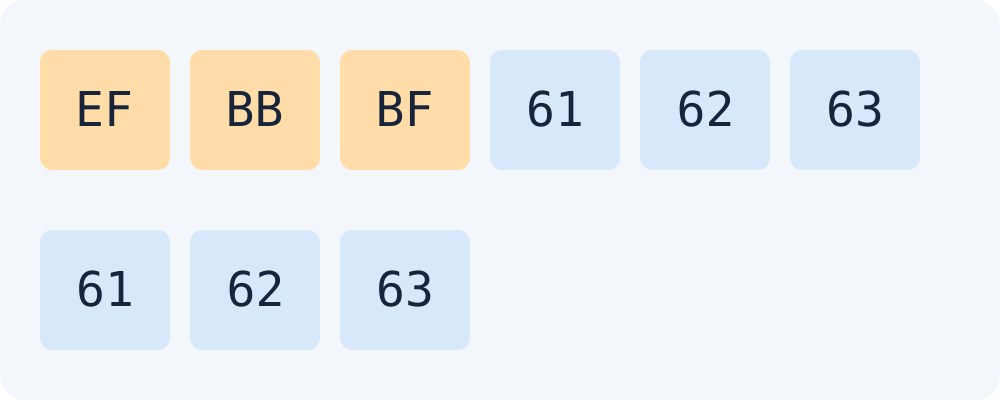
Unicode documenta EF BB BF como BOM UTF-8. É uma assinatura de codificação, não uma troca de ordem dos bytes. O exemplo soma abc, 61 62 63, formando seis bytes. O modo arquivo do Moyoutil lê bytes originais com arrayBuffer; o modo texto usa TextEncoder para UTF-8.
ignoreBOM: true mantém o caractere
Por padrão, TextDecoder omite o BOM inicial e produz abc. Com ignoreBOM em true, esse tratamento é ignorado e U+FEFF permanece. Recodificar a saída padrão dá três bytes e, neste exemplo, um SHA-256 diferente do original de seis bytes. Não generalize para todo editor ou cópia.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3Para comparar o checksum do arquivo original, use o modo arquivo. Colar só abc é outra entrada. Se U+FEFF permanecer na string, seus bytes serão codificados. Não remova o BOM original para forçar igualdade: confira algoritmo e versão do arquivo.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
Perguntas frequentes
U+FEFF no meio também é removido?
Este exemplo só omite o BOM inicial. U+FEFF interno permanece; ignoreBOM: true mantém também o inicial. Executamos o código e a entrada vazia para conferir.