파일에는 EF BB BF가 포함될 수 있습니다
Unicode 문서에서 UTF-8 BOM은 EF BB BF입니다. UTF-8에서 이것은 바이트 순서를 바꾸는 표시가 아니라 인코딩 서명으로 사용됩니다. 예제 파일은 이 세 바이트 뒤에 abc의 61 62 63을 붙인 6바이트입니다. Moyoutil 파일 모드는 arrayBuffer로 원본 바이트를 읽고, 텍스트 모드는 문자열을 TextEncoder로 UTF-8 인코딩합니다.
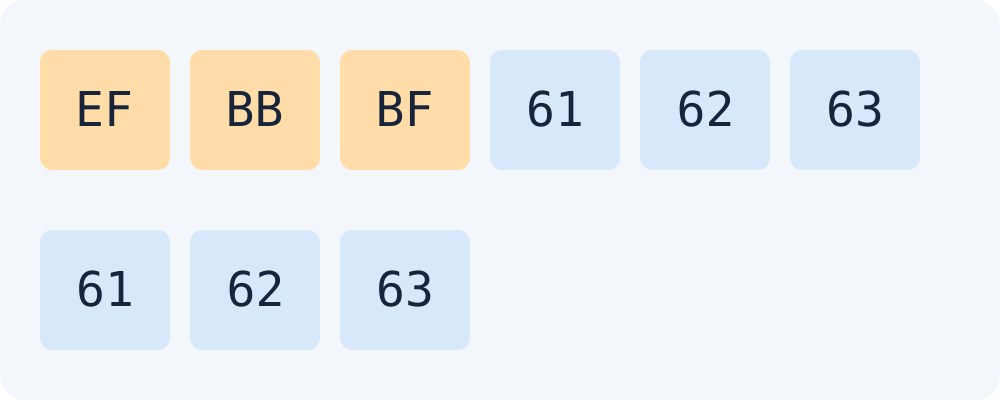
ignoreBOM: true는 오히려 문자를 남깁니다
기본 TextDecoder는 시작 BOM을 출력 문자열에서 제외합니다. 아래 입력의 결과는 abc입니다. ignoreBOM을 true로 주면 BOM 처리 규칙을 건너뛰므로 U+FEFF가 문자열에 남습니다. 기본 디코딩 결과를 다시 인코딩하면 3바이트가 되고, 이 예제의 SHA-256은 6바이트 원본과 다릅니다. 이 동작을 모든 편집기나 복사 과정에 일반화하지 마세요.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3원본 파일의 체크섬을 비교하려면 Moyoutil에서 파일 모드를 선택하세요. 단순히 보이는 abc를 붙여 넣은 텍스트 해시는 다른 입력의 결과입니다. 원문에 U+FEFF가 실제로 남아 있다면 텍스트 인코딩에도 그 바이트가 포함됩니다. 체크섬을 맞추려고 원본의 BOM을 임의로 제거하지 말고 비교 대상의 알고리즘과 파일 버전을 확인하세요.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
자주 묻는 질문
파일 중간의 U+FEFF도 자동 제거되나요?
이 TextDecoder 예제에서는 시작 BOM만 제외합니다. 중간 U+FEFF는 남으며 ignoreBOM: true에서는 시작 문자도 남습니다. 아래 코드와 빈 입력을 직접 실행해 경계 조건을 확인했습니다.