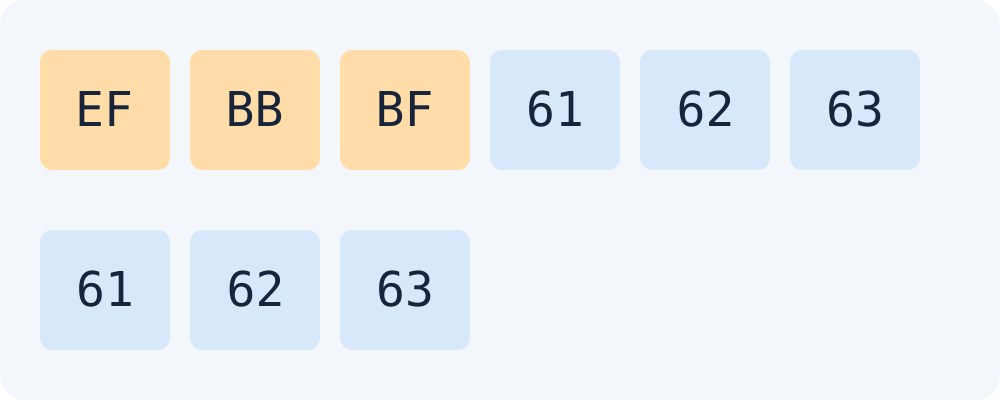
El archivo puede incluir EF BB BF
Unicode documenta EF BB BF como BOM UTF-8. Es una firma de codificación, no un cambio de orden de bytes. El ejemplo añade abc, 61 62 63, para formar seis bytes. El modo archivo de Moyoutil lee bytes originales con arrayBuffer; el modo texto usa TextEncoder para UTF-8.
ignoreBOM: true conserva el carácter
TextDecoder omite por defecto el BOM inicial y produce abc. Con ignoreBOM en true se evita ese tratamiento y queda U+FEFF. Recodificar la salida predeterminada da tres bytes y, en este ejemplo, un SHA-256 distinto del original de seis bytes. No generalices esto a todo editor o proceso de copia.
const bytes = Uint8Array.of(0xEF, 0xBB, 0xBF, 0x61, 0x62, 0x63);
new TextDecoder().decode(bytes) === "abc" // true
new TextDecoder("utf-8", {ignoreBOM: true})
  .decode(bytes) === "\uFEFFabc" // true
new TextEncoder().encode(new TextDecoder().decode(bytes)).length // 3Para comparar la suma del archivo original, usa el modo archivo. Pegar solo abc corresponde a otra entrada. Si U+FEFF sigue en la cadena, se codifican sus bytes. No elimines el BOM original para forzar una coincidencia: comprueba algoritmo y versión del archivo.
new TextDecoder().decode(Uint8Array.of(0x61, 0xEF, 0xBB, 0xBF))
  === "a\uFEFF" // true
Preguntas frecuentes
¿Se elimina U+FEFF en medio?
Este ejemplo solo omite el BOM inicial. El U+FEFF interno permanece; ignoreBOM: true conserva también el inicial. Ejecutamos el código y la entrada vacía para verificarlo.